Claude Real Video
by HUANGCHIHHUNGLeo (community) Claude Desktop, Claude Code, OpenCode, любой MCP-клиент, Python 3.10+, Windows, macOS, Linux
Даёт Claude (или любой LLM) возможность реально «посмотреть» видео — scene-aware дедуплицированные кадры + транскрипт, из URL или локального файла. Работает локально, MIT.
Open-source AI-генератор коротких видео: превращает длинные видео в вирусные шортсы 9:16 с AI-детекцией ключевых моментов, трекингом …
MCP-сервер для прямой загрузки субтитров и транскриптов YouTube-видео. AI-агент получает текстовое содержимое видео по URL для …
MCP-сервер для YouTube от Paul Betts (автор Electron, Squirrel): транскрипты, метаданные видео, поиск и информация о …
Self-hosted MCP-сервер восприятия: транскрибирует речь, читает за логинами, видит изображения и кадры видео, работает через языки, …
pip install "claude-real-video[whisper]"   # recommended: frames + dedup + audio transcription
pip install claude-real-video              # core only (frames + dedup)

brew install ffmpeg           # macOS
sudo apt install ffmpeg       # Linux
winget install Gyan.FFmpeg    # Windows

ffmpeg -version               # проверка доступности в PATH

pip install 'claude-real-video[fast]'   # опционально: faster-whisper вместо whisper
claude-real-video


▶ 60-секундный пиксельный фильм — включите звук (mp4 на GitHub) · агент ИИ ищет "как LLM может по-настоящему понимать видео?", находит ключ и открывает зрение.
60-секундная реальная демонстрация — реальная установка, реальный запуск, реальный просмотр.
Позвольте Claude — или любой другой LLM — действительно смотреть видео.
pip install "claude-real-video[whisper]"
npx skills add HUANGCHIHHUNGLeo/claude-real-video   # one command, installs the skill into Claude Code, Cursor, Codex, Copilot, Gemini CLI & 50+ agent hosts
Магазин плагинов Claude Code (включите автообновление в /plugin → Marketplaces, если хотите):
/plugin marketplace add HUANGCHIHHUNGLeo/claude-real-video
/plugin install claude-real-video@claude-real-video
Затем вставьте ссылку на видео в вашего агента и задайте вопросы о нём. (Только CLI? crv "<url>" работает после установки через pip.)
Название: crv — это сокращённое название для claude-real-video (пакет PyPI). Платное дополнение, crv Pro, продаётся на Capafy под названием "llm-real-video Pro".
▶ Новинка: 40-секундный фильм — мой агент ИИ научился смотреть видео (и перестал работать)
Та же 58-секундная запись: фиксированная выборка 1 кадр в секунду = 58 кадров. crv сохраняет 26, которые действительно отличаются — и
--gridупаковывает их в 3 контактных листа. Меньше токенов, ничего не упущено.Эта бесплатная версия позволяет вашему ИИ видеть видео. crv Pro позволяет ему понимать его — как оно было снято (ритм монтажа, движения камеры), а также временную шкалу с отметками кадров, которые не могут показать: жесты, выражения лица, изменения тона голоса, эмоции, звуковые события. Единовременная цена $29 — приобретите на Capafy или оплатите картой через Lemon Squeezy.
Большинство инструментов ИИ на самом деле не видят видео. Вставьте ссылку на YouTube в ChatGPT, и он прочитает транскрипт, а не изображение. Claude вообще не принимает видеофайлы. Даже Gemini, который может читать видео нативно, должен отправить его на серверы Google и выбирает кадры с фиксированным интервалом (по умолчанию 1 кадр в секунду), поэтому быстрые монтажные склейки ускользают.
claude-real-video делает это иначе, и обработка выполняется локально: укажите URL или файл, и он извлечёт кадры, которые действительно важны (каждую смену сцены, а не по фиксированной квоте), отбросит почти дубликаты, расшифрует аудио и предоставит вам чистую папку, которую сможет прочитать любая LLM. Вся обработка происходит на вашем компьютере — то, что отправляется куда-либо, — это только кадры/текст, которые вы решите вставить в LLM впоследствии.
crv "https://www.youtube.com/watch?v=..."
# → crv-out/frames/*.jpg  +  frames.json (per-frame timestamps)  +  transcript.txt/.json  +  MANIFEST.txt
Затем перетащите кадры + MANIFEST.txt в Claude / ChatGPT / Gemini и задавайте вопросы.
Терминал не нужен — запустите crv-web, и откроется локальная страница (традиционный китайский / упрощённый китайский / английский): вставьте ссылку на YouTube или Reels или путь к файлу, нажмите "Анализировать", откройте просмотр результатов. Анализ видео и генерация вывода выполняются на вашем устройстве — исходное видео никогда не загружается. (Если вы затем вставите извлечённые кадры или транскрипт в облачную LLM, эти данные будут отправлены этому провайдеру.)
Хотите сначала посмотреть, что увидит модель? Добавьте --viewer — он создаст локальный viewer.html (видео + сетка ключевых кадров + транскрипт), который можно открыть двойным щелчком. Без сети, без дополнительных установок.
Важна только часть видео (10-минутный скриншот внутри 90-минутного звонка): --from 28:00 --to 43:00. ffmpeg переходит к нужному месту вместо декодирования всего файла, Whisper слышит только выбранный фрагмент, а бюджет кадров расходуется внутри него — но каждая временная метка, которую сообщает crv, по-прежнему является исходным таймкодом, который вы можете цитировать коллегам.
Смысл в мелких деталях (терминал, таблица, IDE): --frame-width 1600. Выбор кадров — сложная часть, и crv уже справляется с этим; при разрешении 640px в записи экрана шириной 1920 пикселей нужный момент находится, но затем теряется деталь, ради которой его искали.
Медленно меняющийся контент (уроки по анимации, постепенные морфинги, медленные панорамы): добавьте --adaptive — кадры выбираются относительно скользящего окрестности, а не фиксированного порога, поэтому растяжение и сжатие длительностью 2–3 секунды, не вызывающее резких изменений в отдельных кадрах, всё равно будет зафиксировано.
Контент с большим количеством текста (слайды лекций, записи экрана, объяснения с говорящим человеком): добавьте --text-anchors — дополнительные кадры принудительно вставляются на временные метки субтитров, чтобы каждый фрагмент речи сопровождался соответствующим визуальным рядом, даже если сцена почти не меняется. Требуется сторонний файл .srt/.vtt или встроенная дорожка субтитров — субтитры, вшитые в пиксели, не могут быть обнаружены. Не более одного принудительного кадра в секунду; детекция сцен не затрагивается.
Контент с несколькими спикерами (интервью, подкасты, встречи): добавьте --speakers — каждая строка транскрипта получает метку спикера ([SPEAKER_00], [SPEAKER_01], …), чтобы модель могла отслеживать, кто что сказал. Запускается локальная модель диаризации (45 МБ, загружается один раз, не требует аккаунта или токена). Установите с помощью pip install "claude-real-video[speakers]".
Не работаете с LLM? Инструмент также работает как универсальный экстрактор ключевых кадров видео — детекция смены сцен + дедупликация, без загрузки ML-моделей.
Используете Claude Code — или любой другой агент кодинга? Одной командой устанавливается навык (совместимо с Claude Code, Cursor, Codex, Copilot, Gemini CLI и другими agentskills.io-совместимыми хостами):
pip install "claude-real-video[whisper]"
npx skills add HUANGCHIHHUNGLeo/claude-real-video
Затем просто вставьте ссылку на видео в ваш агент и задайте вопрос о нём.
Ручная установка (клонирование + копирование)
git clone https://github.com/HUANGCHIHHUNGLeo/claude-real-video.git
mkdir -p ~/.claude/skills && cp -r claude-real-video/skills/claude-real-video ~/.claude/skills/
Новое в версии 0.3.0 — укажите, зачем вы смотрите видео, и сохраните найденное:
crv "https://youtu.be/..." --why "find the pricing strategy" --kb ~/notes
--why заставляет анализ фокусироваться на том, что важно для вас, а не на общем резюме;
--kb сохраняет результат в виде датированной заметки в вашей папке заметок, чтобы он не терялся в crv-out.
Измеренные показатели
Реальный запуск на 3-минутном видео 640x360 (benchmark/jfk-rice.mp4), Mac mini M4, локальный CPU, только кадры + дедупликация (--no-transcribe). Токены изображений оценены по формуле Anthropic (width x height) / 750 — 307 токенов/кадр при разрешении 640x360.
| Режим | Сохранено кадров | Время выполнения | Оценочные токены изображений |
|---|---|---|---|
| по умолчанию (смена сцены + минимальный интервал 1с) | 170 (из 180 извлечённых) | 23,5 с | ~52 тыс. |
--max-frames 80 |
80 | 23,4 с | ~25 тыс. |
--adaptive (ловит медленные морфинги) |
270 | 36,8 с | ~83 тыс. |
Дедупликация v0.7.16 — быстрые действия небольших объектов больше не исчезают. Процентный компаратор структурно не видит объект, занимающий менее 1% кадра (он никогда не изменит 8% пикселей). Обнаружено в пользовательском пакете из 2181 видео; исправлено с помощью третьего "канала действий". Синтетический пример — статичный кадр 1280x720, объект размером 40x90 пикселей (0,4% кадра) быстро движется только в последних 10 из 65 кадров:
| Сохранено кадров | Сохранено кадров с действием | |
|---|---|---|
| v0.7.15 | 2 | 1 / 10 |
| v0.7.16 | 11 | 10 / 10 — полная траектория |
Почему не просто брать кадры с фиксированным интервалом?
Большинство скриптов "пусть LLM посмотрит видео" (и даже собственный пайплайн Gemini) захватывают кадры
с фиксированным интервалом — например, один кадр в секунду. Это приводит к перевыборке статичных
записей экрана и недовыборке быстро смонтированных роликов. claude-real-video умнее:
| Выборка с фиксированным интервалом | claude-real-video | |
|---|---|---|
| Выбор кадров | каждые N секунд | детекция смены сцен + минимальная плотность |
| Повторяющиеся планы (монтаж A-B-A) | отправляются каждый раз | дедупликация с скользящим окном отправляет каждый план один раз |
| Статичный слайд (10 мин) | ~600 почти идентичных кадров | сжимается до 1 (дедупликация) |
| Быстро смонтированный ролик | пропускает кадры между выборками | ловит каждое визуальное изменение |
| Аудио | часто игнорируется | Транскрипт Whisper с определением языка |
| Где происходит обработка | часто в чужом облаке | на вашем устройстве (вы решаете, чем делиться с LLM потом) |
| Входные данные | обычно только локальный файл | URL (yt-dlp) или локальный файл |
Вы передаёте модели меньше, но более значимых кадров — дешевле контекст, лучше понимание.
Установка
pip install "claude-real-video[whisper]"   # recommended: frames + dedup + audio transcription
pip install claude-real-video              # core only (frames + dedup)
Дополнения pip не устанавливаются автоматически — без [whisper] речь в текст не преобразуется
(видео с собственными субтитрами всё равно получат транскрипт).
Системные требования: ffmpeg
ffmpeg / ffprobe используются для извлечения кадров и аудио и не устанавливаются через pip. Установите их один раз:
| ОС | команда |
|---|---|
| macOS | brew install ffmpeg |
| Linux | sudo apt install ffmpeg (или менеджер пакетов вашего дистрибутива) |
| Windows | winget install Gyan.FFmpeg — или choco install ffmpeg — или скачайте сборку и добавьте её папку bin\ в переменную PATH |
Проверьте, что они доступны в PATH:
ffmpeg -version
Для транскрипции используется CLI whisper (устанавливается через дополнительный пакет [whisper] или pip install openai-whisper). Whisper также зависит от ffmpeg.
Быстрее + защита от галлюцинаций (рекомендуется): установите дополнительный пакет [fast], и crv автоматически переключится на faster-whisper — те же модели, те же выходные файлы, в несколько раз быстрее, и ограничен Silero VAD (детектор голосовой активности): аудио с музыкой или тишиной выдаёт честную заметку "нет речи" вместо придуманных подписей, как у классического whisper. Новые флаги изучать не нужно:
pip install 'claude-real-video[fast]'
Если установлены оба варианта, faster-whisper имеет приоритет; если он когда-либо даст сбой, crv автоматически вернётся к CLI whisper.
Работает на macOS, Windows и Linux — Python 3.10+.
Использование
# A YouTube / Instagram / TikTok / ... link
crv "https://www.instagram.com/reel/XXXX/"

# A local file, English transcript, output to ./out
crv lecture.mp4 -o out --lang en

# Frames only, no transcription
crv clip.mp4 --no-transcribe

# A login-gated video (your own / authorised use): pass a Netscape cookie file
crv "https://..." --cookies cookies.txt
python -m claude_real_video ... также работает как псевдоним для crv.
Параметры
| флаг | по умолчанию | значение |
|---|---|---|
-o, --out |
crv-out |
директория для вывода |
--overwrite |
выключено | заменять предыдущий анализ в выходной директории (без этого флага непустая выходная директория будет отклонена, чтобы избежать смешивания видео) |
--scene |
0.30 |
чувствительность к смене сцен (меньше = больше кадров) |
--fps-floor |
1.0 |
не менее одного кадра каждые N секунд |
--from / --to |
весь файл | анализировать только часть видео (90, 1:30, 0:01:30.5). Указанные временные метки остаются исходными — окно сдвигает анализ, а не таймкод — и бюджет кадров, а также транскрипт следуют за окном, а не за всем файлом |
--frame-width |
640 |
ширина извлечённых кадров, пропорции сохраняются. Увеличивайте её, если смысл заключается в мелком тексте (терминалы, таблицы, плотные панели); большие кадры увеличивают размер выходных данных и стоимость модели |
--max-frames |
авто: clamp(150, окно×1.5, 600) |
жёсткий лимит на общее количество кадров (явное значение всегда имеет приоритет) |
--adaptive |
выключено | адаптивное обнаружение сцен: улавливает медленные трансформации (сжатие/растяжение за 2–3 секунды, постепенные панорамы), которые фиксированный порог пропускает, сравнивая каждый кадр с его скользящим окружением |
--text-anchors |
выключено | принудительно добавлять дополнительные кадры на временных метках субтитров (внешний файл .srt/.vtt или встроенная дорожка) — для видео, где смысл меняется быстрее, чем пиксели; не более одного принудительного кадра в секунду |
--speakers |
выключено | помечать каждую строку транскрипта говорящим ([SPEAKER_00] …) с помощью локальной диаризации — требует pip install "claude-real-video[speakers]", однократная загрузка модели 45 МБ |
--lang |
auto |
язык Whisper (en, zh, auto и т. д.) |
--whisper-model |
base |
модель Whisper для транскрипции (tiny/base/small/medium/large/turbo — base быстрая; хотите более чёткие транскрипты? --whisper-model turbo — в одном флаге: обрезанная large-v3 — намного быстрее, чем large, с незначительной потерей качества, однократная загрузка 1,6 ГБ, ~6 ГБ оперативной памяти) |
--dedup-threshold |
8 |
процент пикселей, которые должны измениться, чтобы кадр считался новым; выше = меньше кадров (порог локального детектора также масштабируется с этим значением) |
--dedup-window |
4 |
сравнивать с последними N сохранёнными кадрами — кадр, который модель уже видела, не вернётся после перебивки (1 = только последовательные) |
--report |
выключено | сохранять отброшенные кадры в ./dropped + создавать report.html с визуализацией каждого решения о сохранении/отбрасывании |
--no-transcribe |
выключено | пропустить аудио |
--keep-audio |
выключено | также сохранять полную звуковую дорожку (audio.m4a), чтобы аудиомодели могли её услышать |
--viewer |
выключено | также создавать viewer.html — просматривать видео, ключевые кадры и транскрипт на одной локальной странице (двойной клик для открытия) |
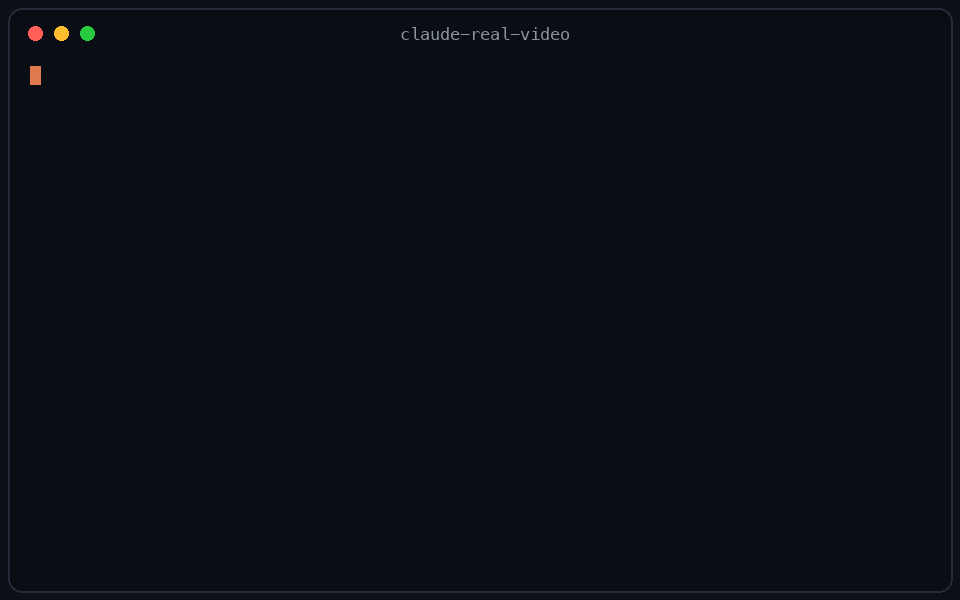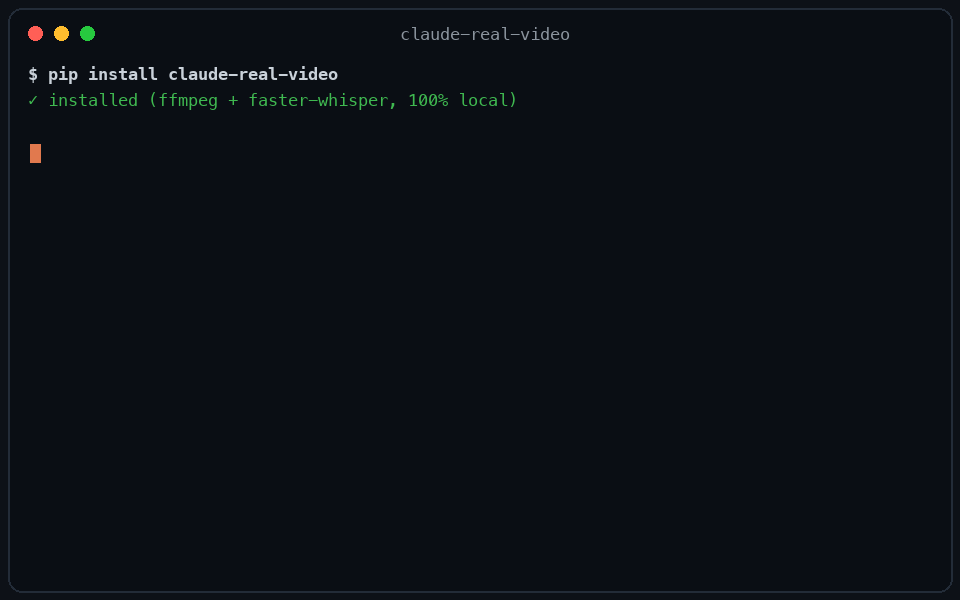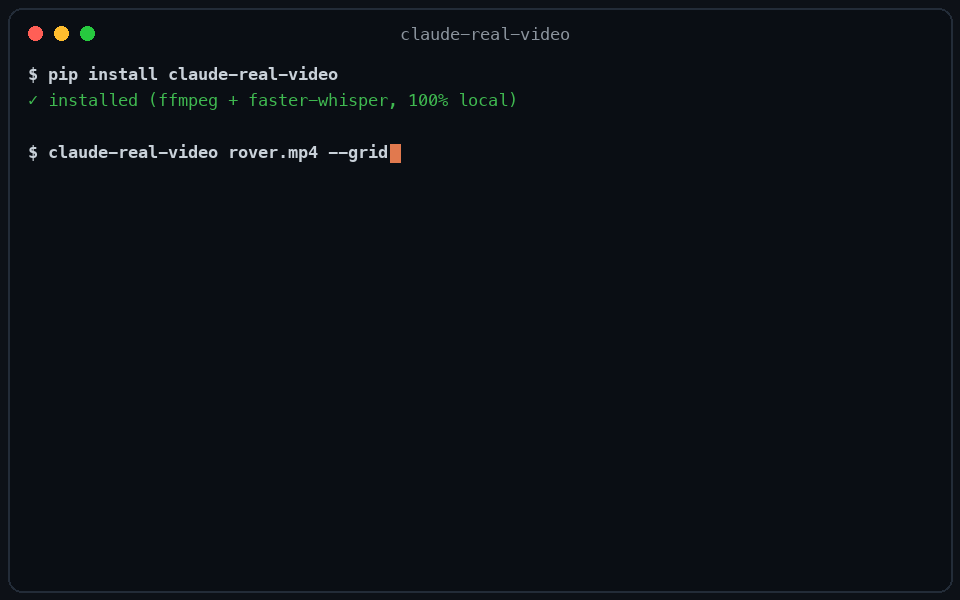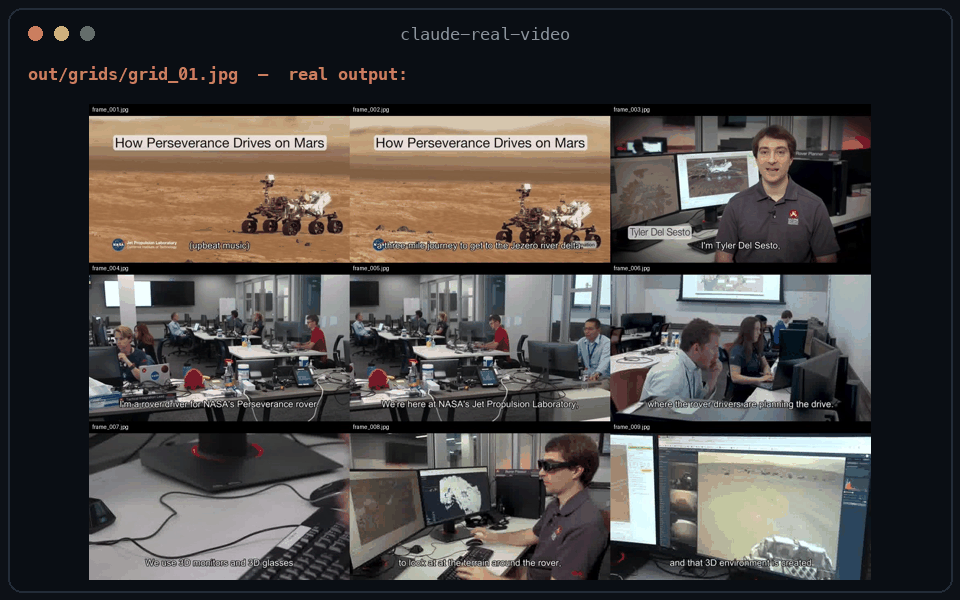
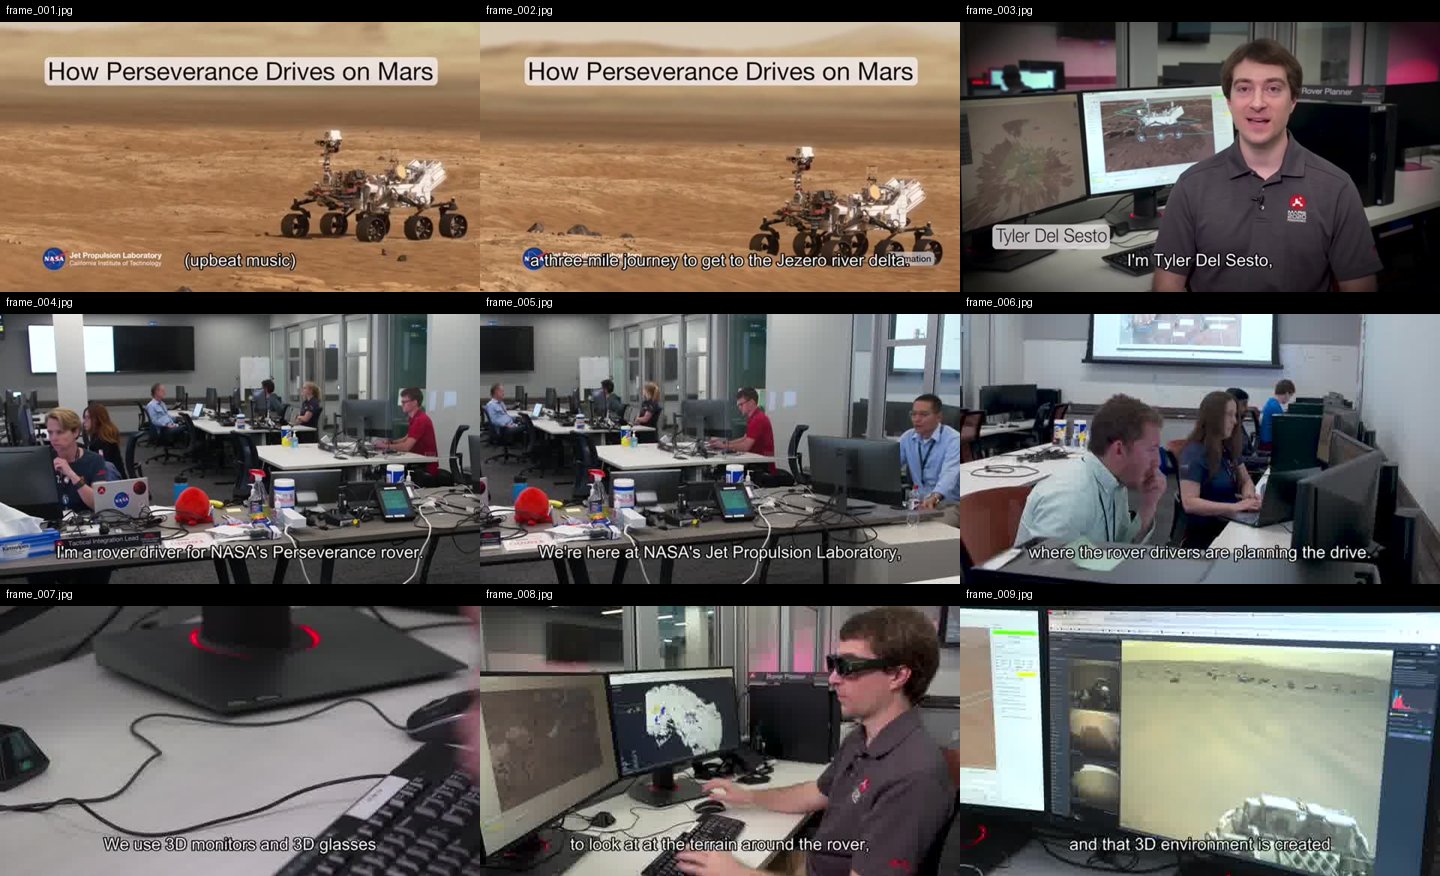
--grid |
выключено | также собирать сохранённые кадры в контактные листы 3×3 (./grids) — последовательные кадры рядом помогают модели отслеживать движение и прогрессию |
--why |
– | причина просмотра, например --why "найти стратегию ценообразования" — записывается в MANIFEST.txt, чтобы модель анализировала с этой точки зрения вместо обобщённого резюме |
--kb |
– | также сохранять анализ в виде датированной заметки в формате markdown в эту папку (ваш Obsidian-валт, каталог заметок и т. д.) — чтобы он пополнил вашу базу знаний вместо того, чтобы исчезнуть в crv-out |
--cookies |
– | файл куки Netscape для источников с авторизацией |
--cookies-from-browser |
– | считывать куки авторизации прямо из вашего браузера — chrome, safari, firefox или edge (только ваш собственный аккаунт) |
Как выглядит вывод --grid
Один контактный лист = девять последовательных ключевых кадров в порядке, с именами файлов в каждой ячейке — модель считывает последовательность, а не разрозненные стоп-кадры:
Память — спрашивайте обо всём, что вы смотрели
Каждый анализ индексируется локально (строки транскрипта + текст на экране с временными метками), поэтому вопрос может охватывать всю вашу библиотеку, а не только одну выходную папку:
crv-ask "pricing strategy"   # → which video, which second, the exact line
crv-ask 定價                  # CJK works — trigram FTS with a substring fallback
crv-ask --list               # everything you've watched, newest first
crv-ask --stats              # where the index lives, how big it is
crv-ask --prune 200          # keep the newest 200 videos, reclaim the space
Повторный запуск того же источника с теми же параметрами не приводит к повторной обработке — crv сообщает "уже просмотрено" и указывает на существующий анализ (0.04 с против нескольких секунд при измерении). Разные параметры или --overwrite запускают повторный анализ как обычно.
Всё хранится локально: одна SQLite-база в ~/.crv/memory.db (можно переопределить с помощью CRV_MEMORY_DB), права только для пользователя, без эмбеддингов, без сети. При первом индексировании чего-либо crv выводит одну строку об этом. Не хотите использовать эту функцию? Установите CRV_NO_MEMORY=1.
MCP-сервер (Claude Desktop / Cursor / любой MCP-клиент)
crv также поставляется в виде MCP-сервера, поэтому MCP-клиенты могут напрямую запрашивать просмотр видео — тот же локальный конвейер, без облака. Пять инструментов: watch_video, get_frames, search_memory (задавайте вопросы по всем просмотренным видео), list_watched (проверяйте перед повторным просмотром) и get_transcript (только слова — без кадров, поэтому длинная беседа не расходует токены изображений).
pip install 'claude-real-video[mcp]'
Код для Claude:
claude mcp add crv -- crv-mcp
Claude Desktop — добавьте в claude_desktop_config.json:
{ "mcpServers": { "crv": { "command": "crv-mcp" } } }
Инструменты: watch_video(source, max_frames, language, transcribe) возвращает транскрипт с временными метками плюс первую партию ключевых кадров в виде изображений; get_frames(source, start_index, count) позволяет пролистывать остальные. Анализы кэшируются в ~/.cache/crv-mcp, поэтому последующие вопросы по тому же видео обрабатываются мгновенно.
mcp-name: io.github.HUANGCHIHHUNGLeo/claude-real-video
Проверено сквозным тестированием на Claude Code (модель корректно описала кадры тестового видео через инструмент). Claude Desktop и Cursor используют тот же MCP-протокол через stdio — конфигурация выше; создайте issue, если что-то работает некорректно.
Использование из Python
from claude_real_video import process

r = process("https://youtu.be/...", "out", lang="en")
print(r.frame_count, r.transcript_path)
Как это работает
- Загрузка —
yt-dlpдля URL (с необязательными куки) или копирование локального файла. - Извлечение — один хронологический проход
ffmpeg selectзахватывает все смены сцен плюс минимальную плотность (хотя бы один кадр каждые--fps-floorсекунд), чтобы покрыть как быстрые монтажные склейки, так и медленные скринкасты. - Дедупликация — три канала сравнения с скользящим окном последних
--dedup-windowсохранённых кадров, чтобы A-B-A-перебивка не отправляла повторно уже виденный моделью кадр. Глобальный канал измеряет реальную разницу пикселей (уменьшенное RGB, а не перцептивный хэш — хэши не замечают однотонные цвета и изменения оттенков с равной яркостью);--dedup-threshold— это процент изменения, который должен быть достигнут. Локальный устоявшийся канал (v0.7.4) отлавливает то, что глобальный не видит: тонкие штрихи пера, смену титров/текстовых карточек и мелкие обновления интерфейса, которые в среднем дают ~0% глобально. Он ищет на более детальной сигнатуре область, которая сильно отличается от всех недавних сохранённых кадров (с допуском в 1 пиксель, чтобы шум плёнки и дрожание кадра не срабатывали) и больше не меняется — устоявшееся новое состояние, а не движение на лету — с кулдауном, чтобы непрерывное движение, останавливающееся каждую секунду (развевающийся флаг, дрейфующий дым), не вызывало постоянных срабатываний. Последний кадр оценивается, даже если движение ещё не прекратилось (чтобы финальное состояние видео не было потеряно), но он должен пройти оба порога контрастности, как и любой другой кадр.--reportсоздаётreport.html, показывающий каждое решение о сохранении/отбрасывании с процентом отличий (сохранённые локальным устоявшимся каналом помечены), для настройки. - Текст — если у видео уже есть субтитры (файл
.srt/.vttрядом с локальным файлом или встроенная дорожка субтитров), они используются как транскрипт — быстрее и точнее, чем повторная транскрипция. Только если субтитров нет, происходит откат к Whisper для аудио (пропускается, если аудио отсутствует).
- Аудио (опционально,
--keep-audio) — сохраняет полную оригинальную звуковую дорожку (audio.m4a: музыка + речь + эффекты, копируется без потерь, когда это возможно). В расшифровке есть только слова; аудиофайл позволяет модели, способной воспринимать звук (Gemini, GPT-4o, …), на самом деле слышать музыку и интонацию. - Временные метки — время исходного видео для каждого сохранённого кадра проходит через весь конвейер (извлечение → дедупликация → прореживание с помощью
--max-frames→ переименование) и записывается вframes.json(file/timestamp_sec/timestamp/selection_reason). Ссылайтесь на визуальные доказательства какframe_012 @ 00:03:41, синхронизируйте кадры с сегментамиtranscript.jsonили передавайте карту в конвейер видео-RAG. Вviewer.htmlщёлкните по любому ключевому кадру → "воспроизвести видео с этого момента". - Манифест —
MANIFEST.txtподводит итог всему для модели.
Таким образом, модель может видеть (ключевые кадры), читать (расшифровку) и — с параметром --keep-audio — слышать (полную звуковую дорожку) видео. Расшифровка — это обычный текст, который может прочитать любая модель; инструмент не встраивает субтитры в видео — встраивание — это выбор для презентации, а не то, что нужно для того, чтобы сделать видео доступным для ИИ.
Примечания
- Скачивайте только тот контент, на который у вас есть права. Опция
--cookiesпредназначена для вашего собственного авторизованного доступа — не размещайте учётные данные в репозитории. - Используйте одну выходную папку для каждого видео. Повторный запуск в папку, где уже есть анализ, отклоняется (чтобы два видео никогда не смешивались); передайте
--overwrite, чтобы заменить его.
crv Pro — понимайте, как снято видео
Бесплатный инструмент предоставляет вашему ИИ ключевые кадры и расшифровку — этого достаточно, чтобы знать, о чём видео. crv Pro добавляет всё остальное: как оно снято, как смонтировано, как произнесено, какое оно вызывает ощущение. Всё вычисляется на вашем компьютере и записывается в виде обычного текста, который может прочитать любой LLM.
- Камера и темп (
--motion) — каждый кадр автоматически помечается: статичный, панорама, наклон, зум, съёмка с рук. Полная таблица кадров: длительность каждого кадра, количество склеек в минуту, темп на протяжении открытия/середины/концовки. Кадры с высокой динамикой получают серию кадров с интервалом 0,2 секунды. - Звук и эмоции (
--senses) — эмоции голоса, кривые интонации и звуковые события (смех, звуковые эффекты, окружающие звуки) с временными метками для каждого сегмента. Голос и музыка автоматически разделяются: эмоции считываются с чистого голоса, музыка получает собственный трек с BPM и энергией. Материал без диалогов (музыкальные клипы, фильмы) переключается на чтение настроения по цвету и освещению. - Интерактивный просмотрщик (
--viewer) — одна самодостаточная веб-страница для каждого анализа: видео, кликабельная временная шкала событий, которая перемещает к нужной секунде, расшифровка, подсвечивающаяся синхронно с воспроизведением. EN / 繁中 / 简中. - Два отчёта, один флаг (
--ai-report) — с вашим собственным API-ключом: один отчёт о том, как снято, другой — о том, что сказано. - Отчёт о разборе (
--breakdown) — анализ крючка, кривая темпа, язык камеры и рубрика, которую ваш собственный LLM дополняет до полного разбора. - Память по всей вашей библиотеке (
crv-pro-ask) — ищите всё, что смотрел Pro, по тому, что делали камера и голос:--camera zoom(все зум-кадры, которые вы когда-либо смотрели),--track emotion --label angry,--rhythm(рейтинг склеек/мин). Бесплатная версияcrv-askищет слова; эти команды ищут измерения, которые бесплатная версия никогда не фиксирует.
Единовременная цена $29:
- Купить на Capafy (мгновенная загрузка, лицензионный ключ включён): https://capafy.ai/agent/llm-real-video-pro-let-any-llm-watch-videos/5451082151
- Купить с помощью кредитной карты (оформление заказа через Lemon Squeezy, мгновенная загрузка): https://leoaido.lemonsqueezy.com/checkout/buy/ff552000-adc0-49f1-8eec-5e8ada1905a1
- Страница продукта и демо: https://leoaido.com/crv-pro/
Следите за разработкой? Я документирую путь от инструмента с открытым исходным кодом до первого платного клиента публично — @LeoAidoAI в X.
Часто задаваемые вопросы
Какой лучший инструмент, чтобы позволить LLM смотреть или анализировать видео?
Это зависит от того, что для вас значит "смотреть". Если вам нужен один ответ по одному клипу и вас не смущает загрузка, то размещённый мультимодальный модель (например, Gemini) — самый короткий путь. Если вы хотите, чтобы любой LLM — Claude, GPT, Gemini или локальная модель — анализировал видео воспроизводимо и локально, вам нужен конвейер предобработки: ключевые кадры с учётом сцен + расшифровка с временными метками, переданные модели в качестве доказательств, на которые она может ссылаться. Именно это делает claude-real-video за одну команду, без отправки данных с вашего компьютера. Равномерная выборка кадров (1 кадр в секунду) либо пропускает склейки, либо перегружает контекстное окно; выборка с учётом сцен сохраняет кадры, несущие информацию.
Как сделать так, чтобы Claude понимал видео?
Claude не может напрямую обрабатывать видеофайлы. Рабочий подход:
pip install "claude-real-video[fast]"
npx skills add HUANGCHIHHUNGLeo/claude-real-video   # or install via the Claude Code plugin marketplace
Затем в Claude Code: Проанализируй это видео: /path/to/video.mp4. Инструмент извлекает ключевые кадры с учётом сцен, расшифровку с временными метками (transcript.json), карту соответствия кадров и временных меток (frames.json) и файл MANIFEST.txt, который объясняет модели, как читать папку — так Claude может ссылаться на frame_012 @ 00:03:41 вместо догадок.
Что такое claude-real-video?
Это CLI-инструмент на Python с лицензией MIT (crv), который превращает видео в то, что LLM может реально прочитать: ключевые кадры с учётом сцен (с сохранением исходных временных меток после дедупликации и переименования), скользящее окно дедупликации, чтобы не терять мелкие движения объектов, и локальная транскрипция с помощью Whisper с возможностью добавления меток говорящих. Работает с YouTube-ссылками или локальными файлами, выполняется полностью локально. Он существует потому, что одних субтитров недостаточно — модели, которые читают только расшифровку, придумывают всё визуальное.
Кто создал этот инструмент
Разработан Лео Хуангом — компанией из одного человека, работающей на базе ИИ. Я публикую информацию о том, что реально ломается и что работает при создании подобных инструментов: https://x.com/LeoAidoAI
Лицензия
MIT