RPG Encoder
by userFRM (community) Claude Desktop, Claude Code, OpenCode, macOS, Linux, Rust 1.85+
MCP-сервер, дающий AI coding-агентам семантическое понимание любой кодовой базы: поиск по намерению, авто-синхронизация при правках, контекст всего репозитория за один вызов. Rust + tree-sitter, 15 языков, 28 инструментов.
MCP-сервер для веб-поиска через Exa AI — поисковик, оптимизированный для нейросетей. В отличие от обычных поисковых …
AI-кодеры ищут вслепую — Cicada даёт им проводника по кодовой базе.
MCP-сервер, дающий AI-агентам персистентную память с семантическим поиском.
Persistent semantic memory для AI-агентов на ChromaDB. Claude запоминает факты, предпочтения и контекст между сессиями, искать …
# Claude Code
claude mcp add rpg -- npx -y -p rpg-encoder rpg-mcp-server

# Cursor — добавить в ~/.cursor/mcp.json
{
  "mcpServers": {
    "rpg": {
      "command": "npx",
      "args": ["-y", "-p", "rpg-encoder", "rpg-mcp-server"]
    }
  }
}

# CLI
npm install -g rpg-encoder

# Build a graph
rpg-encoder build

# Query
rpg-encoder search "parse entities from source code"
rpg-encoder fetch "src/parser.rs:extract_entities"
rpg-encoder explore "src/parser.rs:extract_entities" --direction both --depth 2
rpg-encoder info

# Autonomous lifting via API
rpg-encoder lift --provider anthropic --dry-run  # estimate cost
rpg-encoder lift --provider anthropic            # lift with Haiku (~$0.02/100 entities)

# Incremental update
rpg-encoder update

# Pre-commit hook (auto-updates graph on commit)
rpg-encoder hook install

# Сборка из исходников
git clone https://github.com/userFRM/rpg-encoder.git
cd rpg-encoder && cargo build --release
# затем укажите ваш MCP-конфиг на target/release/rpg-mcp-server
rpg-encoder
Дайте вашему ИИ-агенту мозг для вашей кодовой базы.


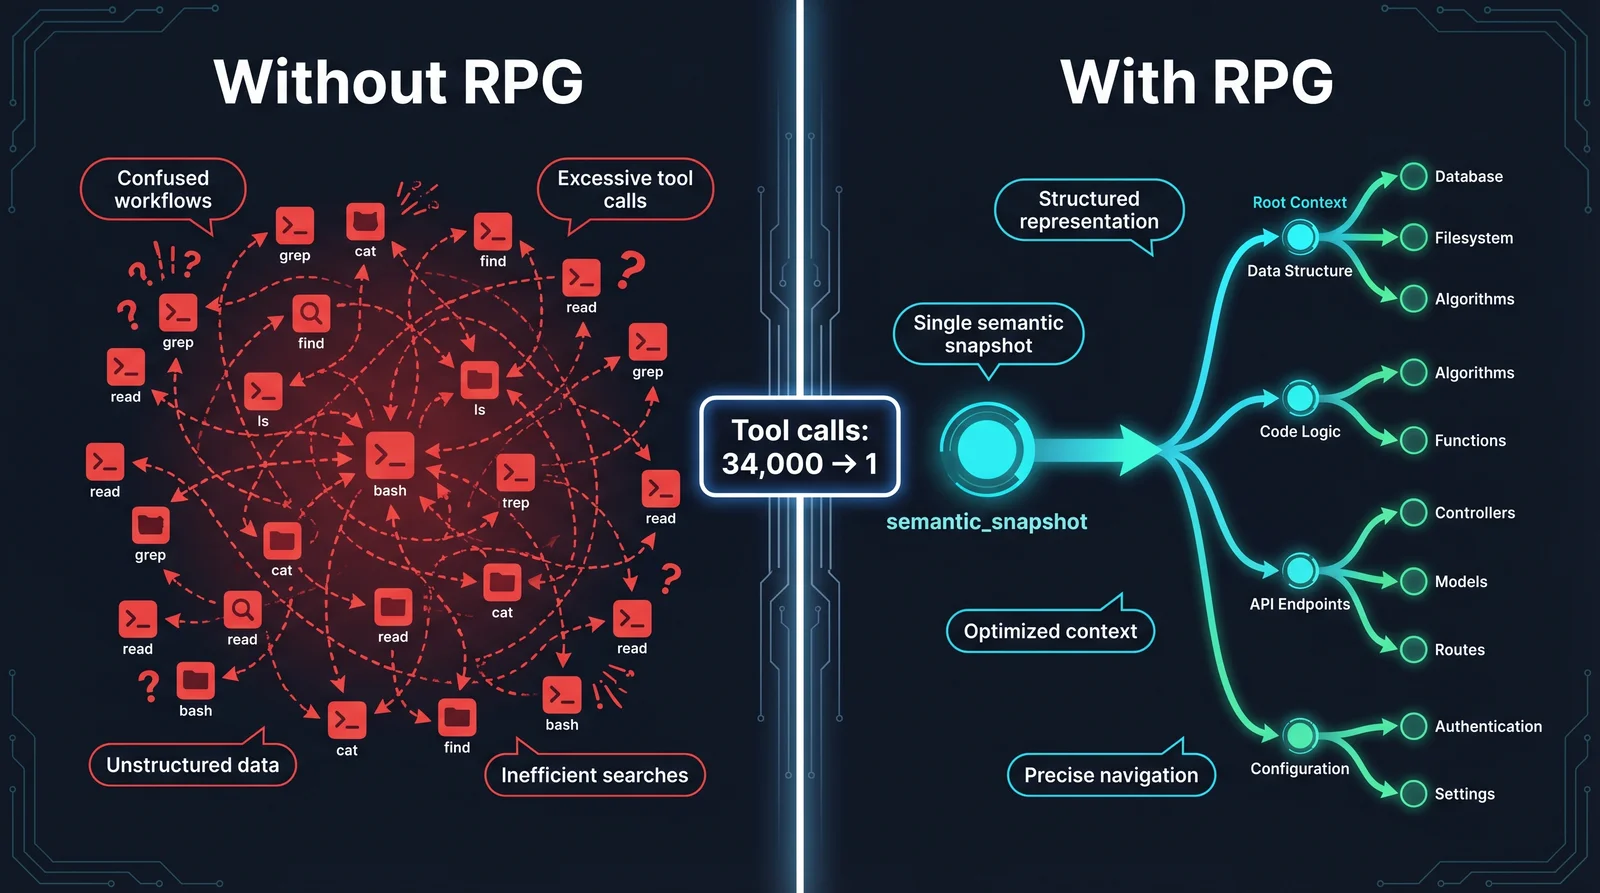
ИИ-агенты для программирования тратят большую часть своих вызовов инструментов на беспорядочные поиски по вашей кодовой базе с помощью grep, cat, find и чтения файлов. rpg-encoder исправляет это. Он строит семантический граф вашего кода с помощью Tree-sitter — не только что вызывает что, но и что делает каждая функция — и даёт вашему ИИ-ассистенту понимание всей репозитория через MCP за один вызов инструмента.
Быстрый старт
claude mcp add rpg -- npx -y -p rpg-encoder rpg-mcp-server
Одна команда. Работает с Claude Code, Cursor, opencode, Windsurf или любым MCP-совместимым агентом. Не нужен Rust-тулчейн, клонирование или сборка — npx загружает готовый бинарник для вашей платформы.
Затем откройте любой репозиторий и скажите вашему агенту:
"Построй и подними RPG для этого репозитория"
Ваш агент сделает всё сам: проиндексирует сущности (секунды), прочитает каждую функцию и добавит признаки уровня намерений (несколько минут), организует их в семантическую иерархию и закоммитит .rpg/graph.json для вашей команды.
Для репозиториев с ~100+ сущностями lifting_status подскажет вашему агенту делегировать цикл подъёма субагенту или более дешёвой модели — извлечение признаков это сопоставление с образцом, а не новое рассуждение. Если в вашем окружении нет механизма субагентов, запустите rpg-encoder lift --provider anthropic|openai из терминала с API-ключом — CLI напрямую управляет внешней LLM без участия агента. После завершения работы CLI вызовите reload_rpg в вашей сессии, чтобы загрузить обновлённый граф. CLI поднимает сущности без признаков; повторный подъём устаревших сущностей (признаки присутствуют, но устарели после изменений кода) обрабатывается внутрисессионным MCP-потоком, а не CLI.
После подъёма попробуйте:
- "Что обрабатывает аутентификацию?" — находит код, даже если ничего не называется "auth"
- "Покажи всё, что зависит от подключения к базе данных"
- "Спланируй изменение для добавления ограничения скорости на API-эндпоинты"
Используйте RPG перед grep, cat, find
Инструкции сервера говорят вашему агенту сначала обращаться к RPG-инструментам для
любых вопросов о структуре или поведении кода. Этот рефлекс важен — grep, cat
и разовые чтения файлов сжигают токены и упускают семантические связи, которые RPG уже знает.
| Если бы вы иначе использовали... | Вместо этого используйте |
|---|---|
grep -r / rg (по намерению) |
search_node(query="...") |
grep -r / rg (по имени) |
search_node(query="...", mode="snippets") |
cat / чтение функции |
fetch_node(entity_id="file:name") |
| цепочки grep для вызывающих/вызываемых | explore_rpg(entity_id="...", direction="...") |
| рекурсивный grep для "что зависит от X" | impact_radius(entity_id="...") |
wc -l / find / tree |
rpg_info |
| чтение многих файлов для контекста | semantic_snapshot |
| ручные цепочки поиск → чтение → исследование | context_pack(query="...") |
| "как безопасно отрефакторить X" | plan_change(goal="...") |
Возвращайтесь к grep, cat или чтению файлов только когда запрос касается буквального текста
(поиск строк, комментарии, TODO, сообщения логов) — не структуры.
Как это работает
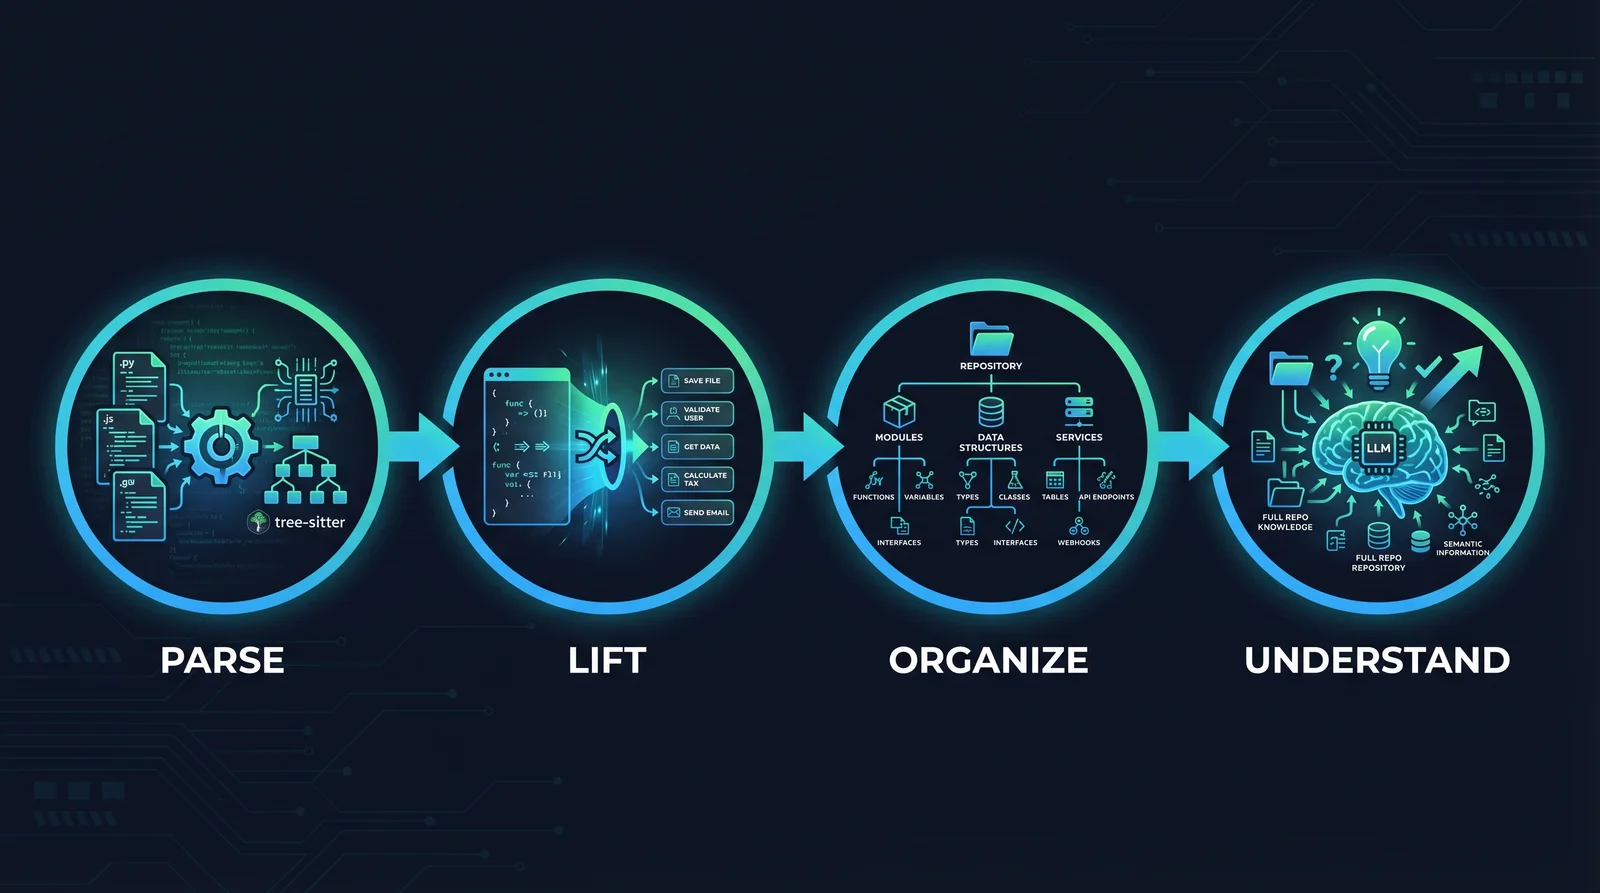
- Parse — Tree-sitter извлекает сущности (функции, классы, методы) и рёбра зависимостей (импорты, вызовы, наследование) из 15 языков.
- Lift — LLM (ваш агент или дешёвый API вроде Haiku) читает каждую сущность и записывает признаки «глагол-объект»: «проверять JWT-токены», «сериализовать конфиг на диск».
- Organize — Признаки группируются в трёхуровневую семантическую иерархию (Область → Категория → Подкатегория), которая формируется на основе того, что делает код, а не файлового дерева.
- Understand —
semantic_snapshotсжимает весь граф до примерно 25K токенов. Ваша LLM читает его один раз и знает репозиторий.
Семантический снимок
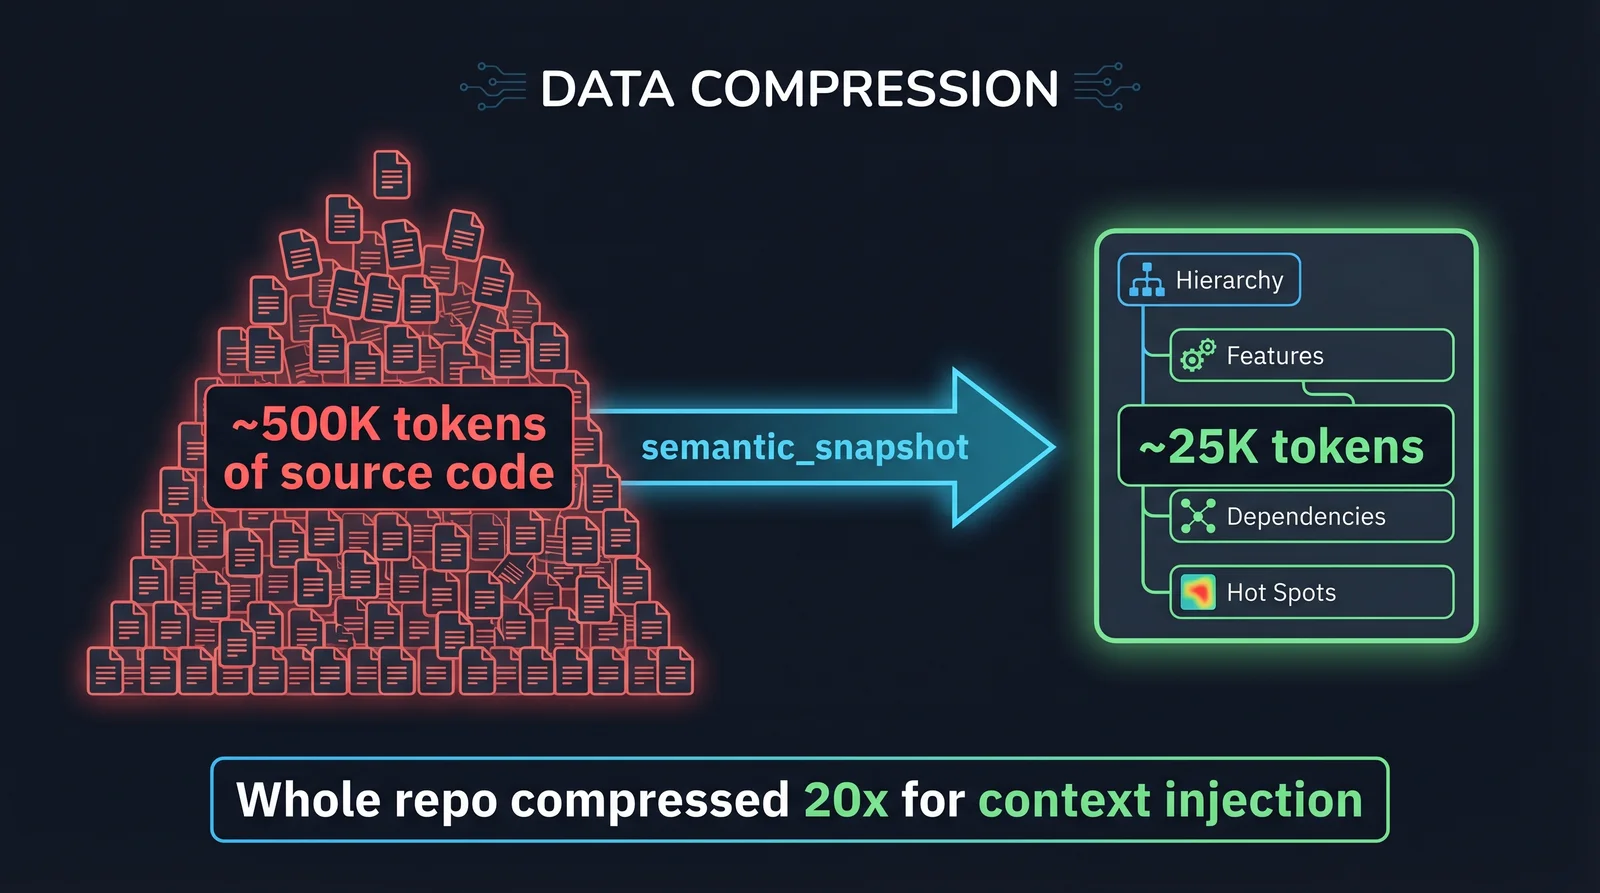
Вместо поиска по файлам LLM вызывает semantic_snapshot один раз и получает:
- Иерархия — каждая функциональная область со сводными признаками
- Сущности — каждая функция, класс, метод, сгруппированные по областям, со своими семантическими признаками
- Скелет зависимостей — сжатый граф вызовов с полными именами
- Горячие точки — топ-10 наиболее связанных сущностей (архитектурный хребет)
~25K токенов покрывают примерно 1000 сущностей. Это 2-3% от окна контекста в 1M — LLM начинает каждую сессию, уже зная ваш репозиторий.
Самоподдерживающийся граф
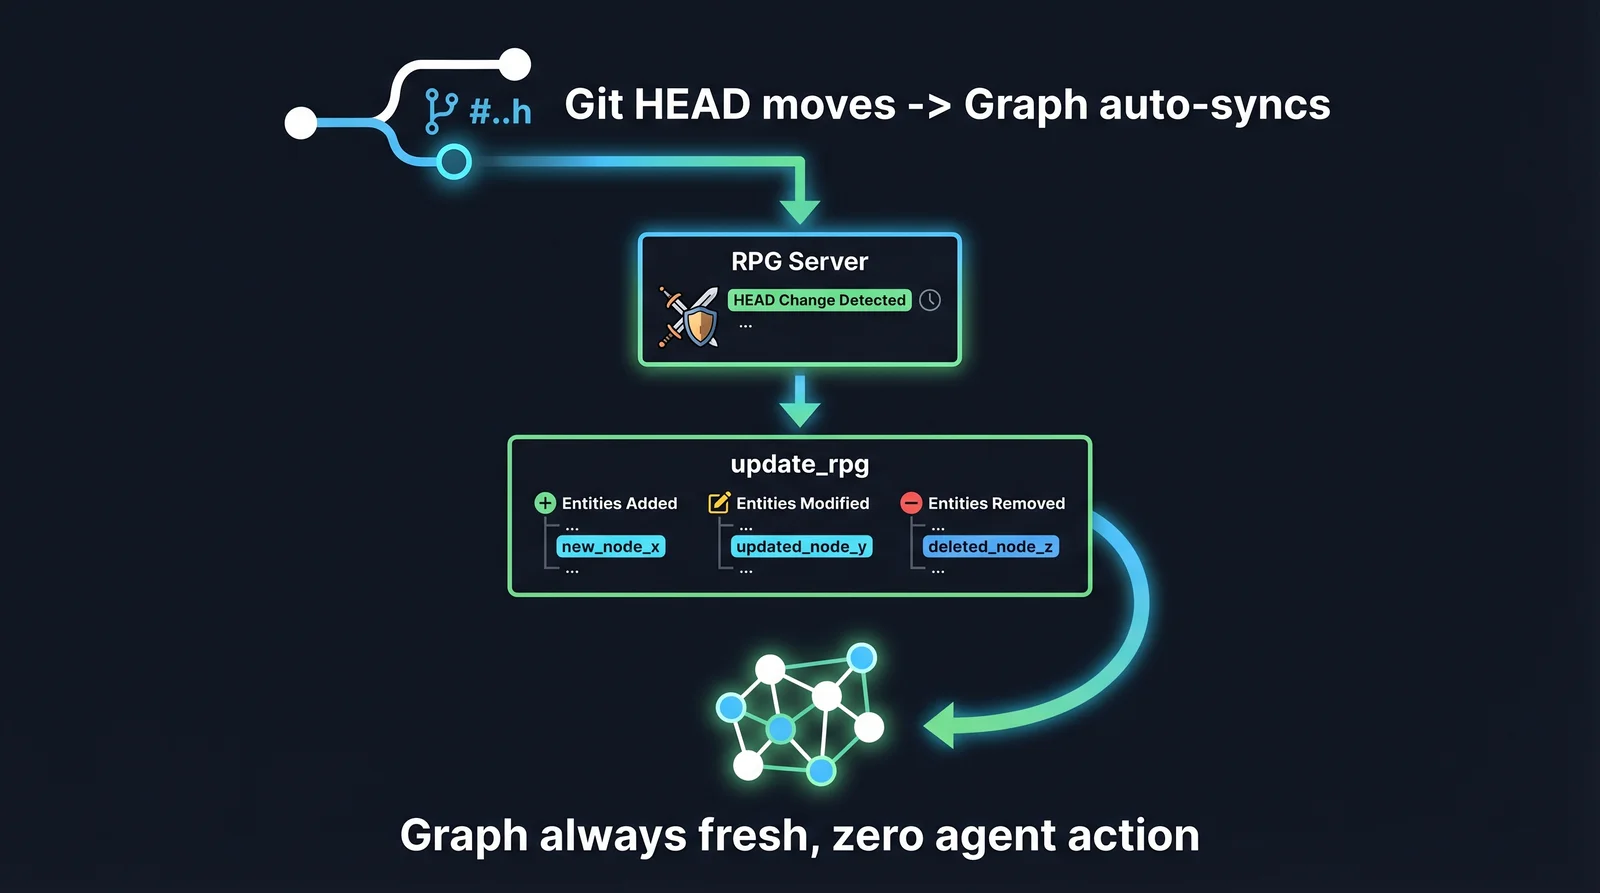
При любом изменении рабочего дерева — закоммиченном, в staging или нет — MCP-сервер автоматически персинхронизируется перед ответом на следующий запрос. Хеш изменений по (path, size, mtime) означает, что повторные сохранения одного и того же файла вызывают одну синхронизацию, а запросы в простое не вызывают никакой. Откаты также обнаруживаются: если ранее изменённый файл возвращается к состоянию HEAD, граф восстанавливается.
Два способа подъёма (lifting)
| Режим | Команда | Стоимость | Кто платит |
|---|---|---|---|
| Агентский подъём | «Построй и подними RPG» | Токены подписки | Ваша подписка Claude Code / Cursor |
| Автономный подъём | auto_lift(provider="anthropic", api_key_env="ANTHROPIC_API_KEY") |
~$0.02 за 100 сущностей | Внешний API-ключ (Haiku, GPT-4o-mini, OpenRouter, Gemini) |
auto_lift вызывает дешёвую внешнюю LLM напрямую — ваша подписка на кодинг никогда не касается работы по подъёму. Используйте api_key_env для разрешения ключей из переменных окружения, чтобы они никогда не появлялись в транскриптах вызовов инструментов.
Архитектура
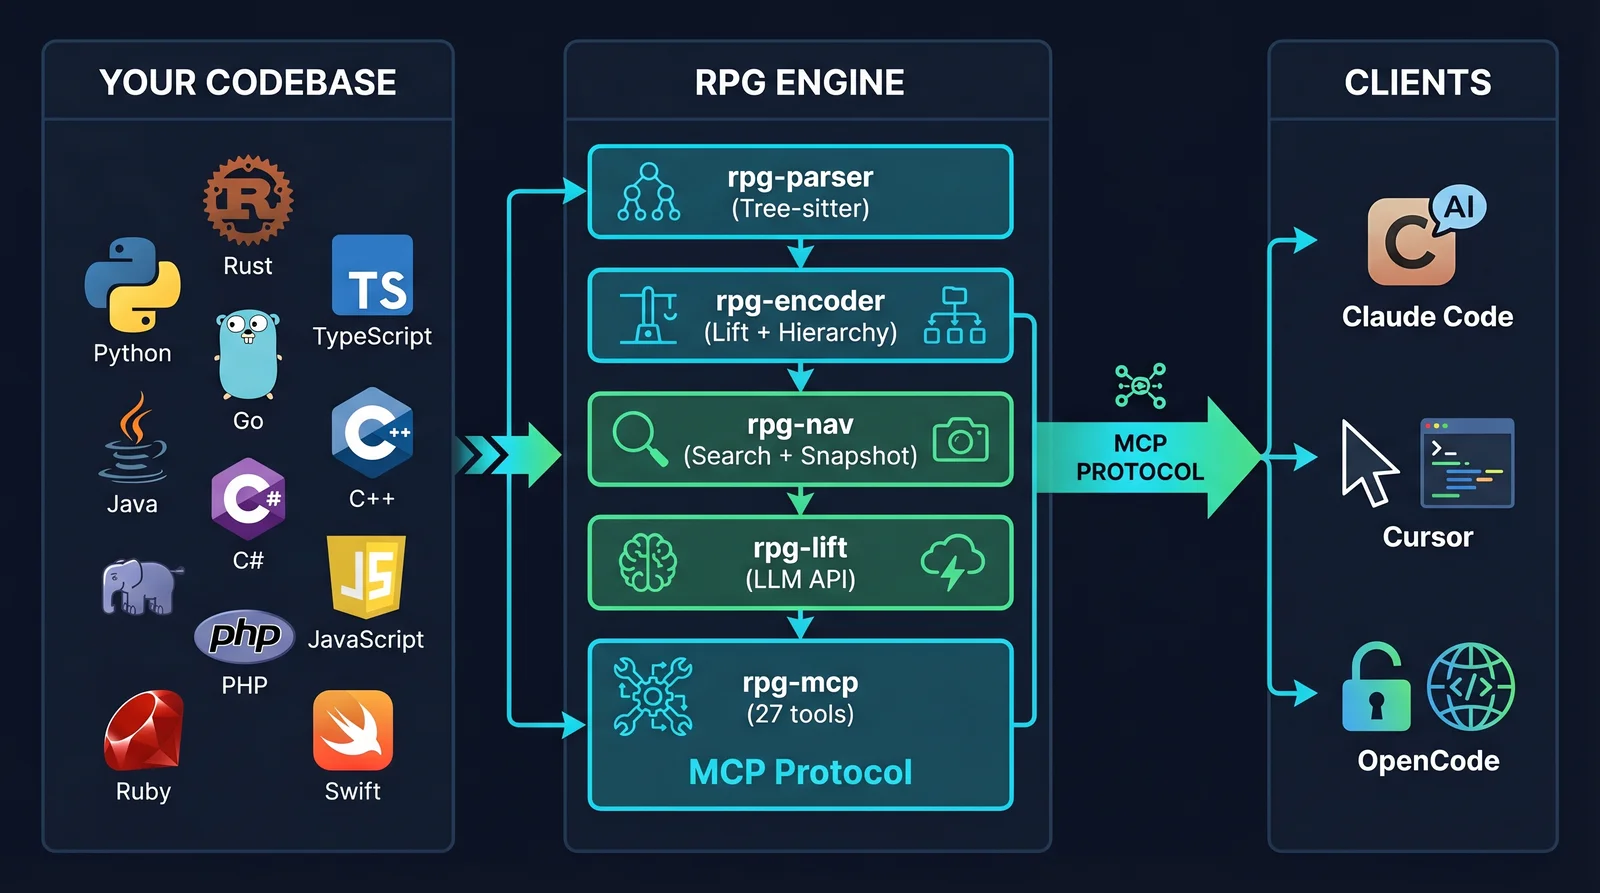
Семь Rust-крейтов, один бинарник MCP-сервера, один бинарник CLI:
| Крейт | Роль |
|---|---|
rpg-core |
Типы графа (RPGraph, Entity, HierarchyNode), хранилище, алгоритм LCA |
rpg-parser |
Tree-sitter извлечение сущностей и зависимостей (15 языков) |
rpg-encoder |
Конвейер кодирования, утилиты подъёма, инкрементальная эволюция |
rpg-nav |
Поиск, выборка, исследование, снимок, сериализация TOON |
rpg-lift |
Автономный LLM-подъём (Anthropic, OpenAI, OpenRouter, Gemini) |
rpg-cli |
Бинарник CLI (rpg-encoder) |
rpg-mcp |
Бинарник MCP-сервера (rpg-mcp-server) с 27 инструментами |
MCP-инструменты (27)
Сборка и обслуживание (4 инструмента)
| Инструмент | Описание |
|---|---|
build_rpg |
Индексация кодовой базы (запускается один раз, мгновенно) |
update_rpg |
Инкрементальное обновление из git-изменений |
reload_rpg |
Перезагрузка графа с диска после внешних изменений |
rpg_info |
Статистика графа, обзор иерархии, покрытие подъёма по областям |
Навигация и поиск (5 инструментов)
| Инструмент | Описание |
|---|---|
semantic_snapshot |
Полное семантическое понимание репозитория за один вызов (~25K токенов на 1000 сущностей) |
search_node |
Поиск сущностей по намерению или ключевым словам (гибридное эмбеддинг + лексическое ранжирование) |
fetch_node |
Получить метаданные сущности, исходный код, зависимости и контекст иерархии |
explore_rpg |
Обход графа зависимостей (восходящие, нисходящие или оба направления) |
context_pack |
Поиск + получение + обход за один вызов с бюджетом токенов |
Планирование и анализ (7 инструментов)
| Инструмент | Описание |
|---|---|
impact_radius |
BFS-анализ достижимости — «что зависит от X?» |
plan_change |
Планирование изменений — поиск релевантных сущностей, порядок модификации, радиус поражения |
find_paths |
K кратчайших путей зависимостей между двумя сущностями |
slice_between |
Извлечение минимального связующего подграфа между сущностями |
analyze_health |
Здоровье кода: связанность, нестабильность, божественные объекты, обнаружение клонов |
detect_cycles |
Поиск циклических зависимостей и архитектурных циклов |
reconstruct_plan |
План выполнения реконструкции с учётом зависимостей |
Семантический подъём (11 инструментов)
| Инструмент | Описание |
|---|---|
auto_lift |
Автономный подъём за один вызов через дешёвый LLM API (Haiku, GPT-4o-mini, OpenRouter, Gemini) |
lifting_status |
Панель управления — покрытие, прогресс по областям, СЛЕДУЮЩИЙ ШАГ |
get_entities_for_lifting |
Получить исходный код сущностей для анализа вашим агентом |
submit_lift_results |
Отправить семантические признаки агента обратно в граф |
finalize_lifting |
Агрегировать признаки уровня файлов, перестроить метаданные иерархии |
get_files_for_synthesis |
Получить признаки сущностей уровня файлов для целостного синтеза |
submit_file_syntheses |
Отправить целостные сводки уровня файлов |
build_semantic_hierarchy |
Получить обнаружение доменов + промпты назначения иерархии |
submit_hierarchy |
Применить назначения иерархии к графу |
get_routing_candidates |
Получить сущности, требующие семантической маршрутизации (дрейфовавшие или недавно поднятые) |
submit_routing_decisions |
Отправить решения о маршрутизации (путь иерархии или «оставить») |
Поддерживаемые языки
15 языков через Tree-sitter:
| Язык | Извлечение сущностей | Разрешение зависимостей |
|---|---|---|
| Python | Функции, классы, методы | импорты, вызовы, наследование |
| Rust | Функции, структуры, трейты, методы impl | use, вызовы, реализации трейтов |
| TypeScript | Функции, классы, методы, интерфейсы | импорты, вызовы, наследование |
| JavaScript | Функции, классы, методы | импорты, вызовы, наследование |
| Go | Функции, структуры, методы, интерфейсы | импорты, вызовы |
| Java | Классы, методы, интерфейсы | импорты, вызовы, наследование |
| C / C++ | Функции, классы, методы, структуры | include, вызовы, наследование |
| C# | Классы, методы, интерфейсы | using, вызовы, наследование |
| PHP | Функции, классы, методы | use, вызовы, наследование |
| Ruby | Классы, методы, модули | require, вызовы, наследование |
| Kotlin | Функции, классы, методы | импорты, вызовы, наследование |
| Swift | Функции, классы, структуры, протоколы | импорты, вызовы, наследование |
| Scala | Функции, классы, объекты, трейты | импорты, вызовы, наследование |
| Bash | Функции | source, вызовы |
Установка
MCP-сервер (рекомендуется)
# Claude Code
claude mcp add rpg -- npx -y -p rpg-encoder rpg-mcp-server

# Cursor — add to ~/.cursor/mcp.json
{
  "mcpServers": {
    "rpg": {
      "command": "npx",
      "args": ["-y", "-p", "rpg-encoder", "rpg-mcp-server"]
    }
  }
}
Сервер автоматически определяет корень проекта из текущей рабочей директории — аргумент пути не требуется.
CLI
npm install -g rpg-encoder

# Build a graph
rpg-encoder build

# Query
rpg-encoder search "parse entities from source code"
rpg-encoder fetch "src/parser.rs:extract_entities"
rpg-encoder explore "src/parser.rs:extract_entities" --direction both --depth 2
rpg-encoder info

# Autonomous lifting via API
rpg-encoder lift --provider anthropic --dry-run  # estimate cost
rpg-encoder lift --provider anthropic           # lift with Haiku (~$0.02/100 entities)

# Incremental update
rpg-encoder update

# Pre-commit hook (auto-updates graph on commit)
rpg-encoder hook install
Сборка из исходников
git clone https://github.com/userFRM/rpg-encoder.git
cd rpg-encoder && cargo build --release
Затем укажите ваш MCP-конфиг на target/release/rpg-mcp-server.
Документация
- Как RPG сравнивается — честное сравнение с GitNexus, Serena, Repomix и другими
- Точность статьи — поалгоритмное сравнение с исследовательской статьёй
- Варианты использования — практические примеры того, что даёт RPG
- CHANGELOG — история релизов
Вдохновение и ссылки
rpg-encoder построен на теоретической основе исследовательской статьи RPG-Encoder, с оригинальными расширениями, вдохновлёнными инструментами в сфере интеллектуального анализа кода:
- Статья RPG-Encoder (Luo et al., 2026, Microsoft Research) — модель семантического подъёма, построение иерархии из 3 уровней, инкрементальные алгоритмы эволюции, формальная графовая модель G = (V_H ∪ V_L, E_dep ∪ E_feature).
- GitNexus — предвычисленный реляционный интеллект, анализ радиуса поражения, хуки Claude Code. Показал, что инструмент для графа кода должен быть невидимым, чтобы быть необходимым.
- Serena — точность на уровне символов через LSP. Продемонстрировал, что осведомлённость о коде в реальном времени важнее пакетного анализа.
- TOON — объектная нотация, ориентированная на токены, для вывода, оптимизированного под LLM.
Это независимая реализация. Весь код является оригинальной работой под лицензией MIT. Не связан с Microsoft и не одобрен ею.