DeepMem
by deepmemteam (community) Claude Desktop, Claude Code, OpenCode, Mem0 API, Python, Docker, Windows, macOS, Linux
Drop-in слой AI-памяти: в 2 раза быстрее отклик, в 10 раз дешевле. Полностью совместим с Mem0 API, миграция за 5 минут без изменения кода. Self-host бесплатно.
Показывает, что coding-агенты уже знают о проекте. Docmancer индексирует память, правила и инструкции, которые Claude Code, …
Биологически вдохновлённый движок персистентной памяти для Claude Code. 26 когнитивных подсистем, сети Хопфилда, предиктивное кодирование, каузальный …
Минималистичная расширяемая agent-native база знаний, поддерживающая общий контекст актуальным и инспектируемым.
MCP-сервер, дающий AI-агентам персистентную память с семантическим поиском.
# Клиентская библиотека
pip install deepmem-client

# Вариант 1: Docker Compose
cp .env.example .env          # add an LLM key
docker compose up --build     # DeepMem (HTTP :8000 + MCP :8001) + Qdrant sidecar
curl http://localhost:8000/health

# Или готовый образ из Docker Hub
docker pull langdeepmem/deepmem:latest
docker run -p 8000:8000 -p 8001:8001 -e DEEPSEEK_API_KEY=sk-... langdeepmem/deepmem:latest

# Вариант 2: из исходников
git clone https://github.com/deepmemteam/deepmem.git && cd deepmem
pip install -r requirements.txt
cp .env.example .env          # add an LLM key + embedder config
python server/start.py        # HTTP :8000 + MCP :8001
DeepMem
Готовый слой памяти ИИ с вдвое более быстрым откликом и в 10 раз меньшей стоимостью.
Полностью совместим с API Mem0. Миграция за 5 минут — одна строка импорта.


Облако · Самостоятельное развёртывание · Бенчмарки · Воспроизведите их
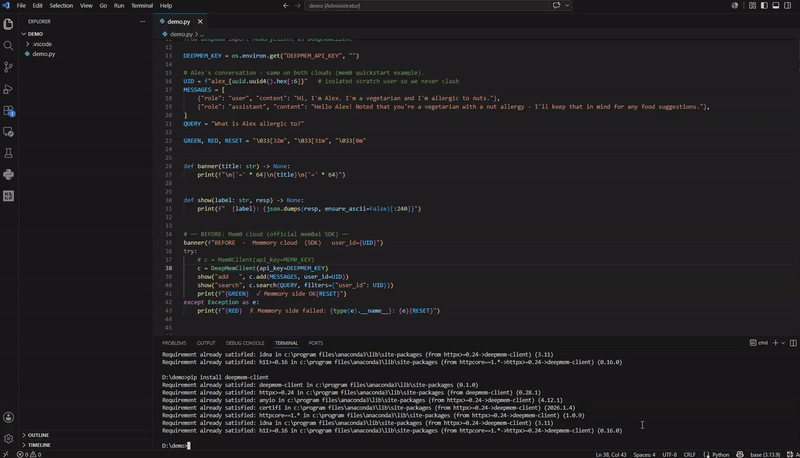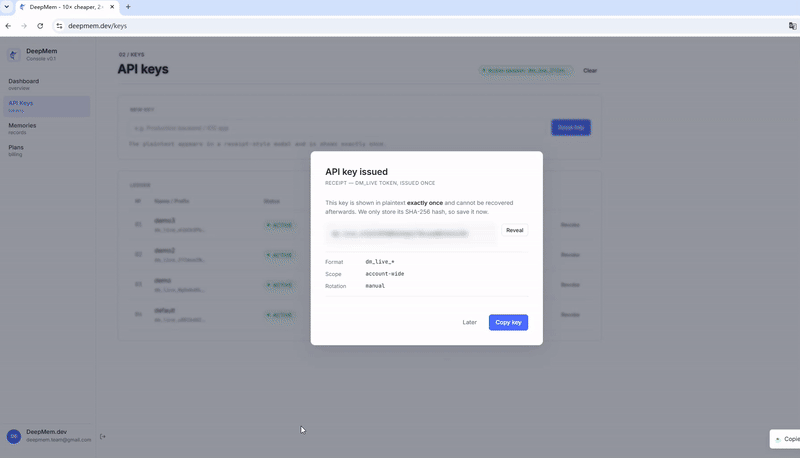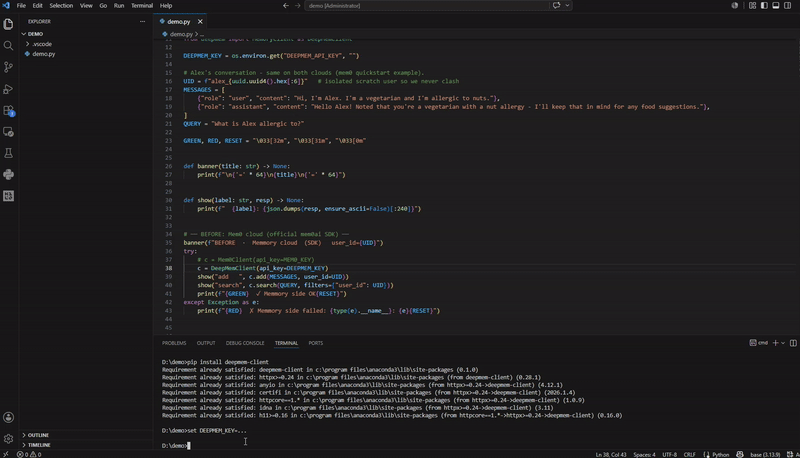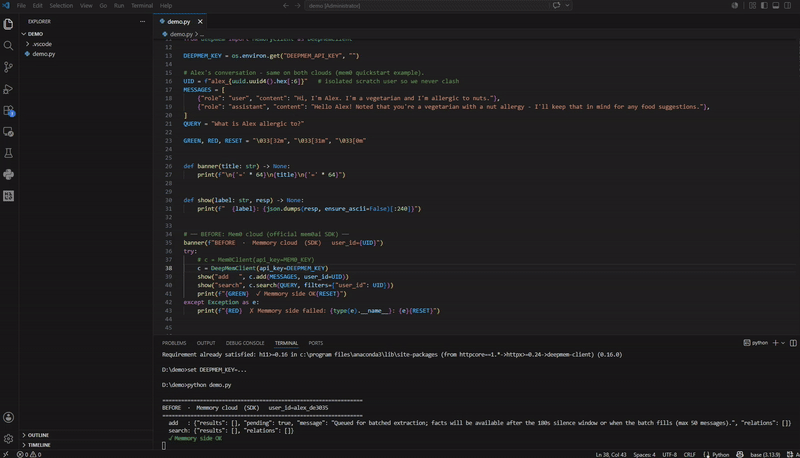
Миграция с Mem0 в одну строку — тот же MemoryClient, те же сигнатуры методов:
# Before - Mem0
from mem0 import MemoryClient
client = MemoryClient(api_key="m0-...")

# After - DeepMem (only the import changes)
from deepmem import MemoryClient
client = MemoryClient(api_key="dm_live-...")   # get a key at deepmem.dev
pip install deepmem-client
Превращайте беседы в доступную для поиска долговременную память: HTTP API на базе FastAPI перед векторным хранилищем Qdrant с извлечением фактов с помощью LLM, гибридным поиском (векторный + BM25 + усиление сущностей + затухание по времени), семантическим кэшированием, асинхронной пакетной дистилляцией, средствами контроля GDPR и встроенным сервером MCP. Работает в открытом режиме — без API-ключей, без регистрации пользователей — так что вы можете развернуть его для своих агентов за считанные минуты. Многопользовательская изоляция обеспечивается параметром user_id в теле запроса.
Не хотите развёртывать самостоятельно? DeepMem Cloud — это управляемая версия этого же движка на deepmem.dev — тот же API, без инфраструктуры. Зарегистрируйтесь, получите ключ (
dm_live_...), укажите базовый URLhttps://deepmem.dev, готово. Облако и сервер с открытым исходным кодом используют один и тот же совместимый с Mem0 API, поэтому клиентский код идентичен.
Миграция с Mem0
Уже используете Mem0? Переключитесь на облако DeepMem в одну строку. Пакет deepmem-client повторяет mem0.MemoryClient — то же имя класса, те же сигнатуры методов, тот же стиль filters={"user_id": ...} — так что всё после импорта остаётся без изменений.
pip install deepmem-client
# before (Mem0)
from mem0 import MemoryClient
client = MemoryClient(api_key="m0-...")
client.add(messages, user_id="alex")
client.search("What can Alex cook?", filters={"user_id": "alex"})

# after (DeepMem cloud) - change one import line
from deepmem import MemoryClient
client = MemoryClient(api_key="dm_live_...")        # key at https://deepmem.dev
client.add(messages, user_id="alex")                # identical calls
client.search("What can Alex cook?", filters={"user_id": "alex"})
Особенности поведения
add(infer=True)(по умолчанию) асинхронный в облаке DeepMem — возвращаетpending=Trueсresults=[], а извлечённые факты появляются через несколько секунд. (В облаке Mem0addтоже асинхронный — возвращаетPENDING.) Передайтеinfer=Falseдля синхронного хранения исходного текста, который сразу доступен для поиска.- Нет графовых связей — DeepMem использует гибридный векторный поиск (векторный + BM25 + затухание по времени), поэтому
relationsвсегда[]. Графовые функции Mem0 не воспроизводятся. resetотличается — в Mem0 это действие на уровне аккаунта; в DeepMem — на уровнеuser_idс защитным подтверждением.
Цены
Облако DeepMem в 10 раз дешевле Mem0 на каждом платном уровне — те же планы, но в десять раз дешевле.
| Уровень | DeepMem | Облако Mem0 |
|---|---|---|
| Хобби | Бесплатно | Бесплатно |
| Стартовый | $1.9/мес | $19/мес |
| Рост | $7.9/мес | $79/мес |
| Профессиональный | $24.9/мес | $249/мес |
Вместо этого разверните самостоятельно — и это будет $0 — вы платите только своему поставщику LLM/эмбеддингов (те же затраты на LLM, которые Mem0 добавляет сверх стоимости плана), без наценки за сервис памяти. Пакетная дистилляция также сокращает вызовы LLM примерно на 80%, так что даже ваш счёт у поставщика будет меньше, чем при извлечении на каждое сообщение.
Планы и ограничения: deepmem.dev · mem0.ai.
Бенчмарки
Никакого отбора лучших результатов. Скрипты и рабочая нагрузка поставляются в /benchmarks — запустите их самостоятельно. Вот что мы измерили и точная конфигурация, которая это обеспечила:
| Метрика | DeepMem самостоятельно ¹ | DeepMem облако | Облако Mem0 |
|---|---|---|---|
| Поиск p50 | 73 мс | 643 мс | 653 мс |
| Поиск p95 | 86 мс | 811 мс | 710 мс |
| Попадания в поиске (40 запросов) | - | 195 | 84 |
| Добавление p50 (хранение исходного текста) | 899 мс ² | 792 мс | 695 мс ³ |
> ¹ BGE-M3 на GPU GTX 1070 (2016 года), локальный файловый Qdrant, infer=False,
100 операций, параллелизм 1. ² Преобладает локальный ввод-вывод Qdrant — сервер Qdrant резко сокращает это время. ³ У Mem0 нет режима хранения сырых данных;
addвсегда запускает извлечение с помощью LLM, поэтому эта строка не является сравнением «яблоки с яблоками».
- Самостоятельный хостинг — это место, где живёт внутренняя задержка — нет задержки RTT в интернете, ваш эмбеддер, ваш Qdrant. 73 мс — медианное время поиска на старом потребительском GPU.
- Облако DeepMem превосходит облако Mem0 по медианному времени поиска (643 мс против 653 мс) и возвращает примерно в 2,3 раза больше кандидатов на один поиск (195 против 84 попаданий по 40 запросам).
- Задержка в облаке определяется RTT — оба облачных столбца измерялись через прокси из материкового Китая; разброс между запусками составляет ~±10%. Запустите
/benchmarksиз локации с низким RTT, чтобы получить свои собственные данные.
Зачем нужен DeepMem
Фреймворки для агентов постоянно приходят к выводу, что им необходима постоянная память с возможностью поиска. Облачные решения выставляют счёт за каждый вызов и отправляют ваши данные в чужое облако. DeepMem — это альтернатива для самостоятельного хостинга: тот же API в формате Mem0, который можно подключить, но он работает на вашем оборудовании, с вашим эмбеддером, вашим ключом LLM и вашим Qdrant — а код доступен здесь для проверки.
Как DeepMem сравнивается с другими альтернативами Mem0? Большинство из них доступны только в облаке или накладывают память поверх чужой векторной базы данных. DeepMem сочетает три вещи одновременно: он поддерживает самостоятельный хостинг (ваши данные остаются на вашем оборудовании — $0 сверх вашего собственного ключа LLM), нативен для MCP (Claude Desktop / Cursor могут напрямую читать и записывать воспоминания как инструменты) и полностью открыт — а управляемое облако работает на том же движке, поэтому облако и самостоятельный хостинг используют один API, а не два продукта.
| Без DeepMem | С DeepMem |
|---|---|
| Каждый сеанс приходится заново объяснять, кто вы и над чем работаете | Агент автоматически вспоминает личность, проекты и предпочтения |
| Теряется контекст отладки и исследований между сеансами | Вспоминаются прошлые причины проблем, тупики и находки, чтобы работа не повторялась |
| Каждый сеанс приходится заново формулировать предпочтения | Предпочтения сохраняются между сеансами, агентами и проектами |
| Облачные сервисы памяти, которые выставляют счёт за каждый вызов и хранят ваши данные | Самостоятельный хостинг на вашей инфраструктуре или использование облака — ваш выбор, тот же API |
Что это на самом деле
- Гибридный поиск, а не граф знаний. Поиск объединяет векторное сходство, ключевое соответствие BM25, усиление сущностей и временное затухание оценки. Здесь нет временного слоя графа; если это то, что вам нужно, обратите внимание на Zep.
- Хранит предпочтения, а не дампы кода. Большие блоки кода в ограждениях удаляются перед извлечением фактов с помощью LLM, поэтому хранилище заполняется долговременными фактами о пользователе/проекте, а не вставленными реализациями.
- BYOK, поддержка нескольких провайдеров. Принесите свою собственную LLM (OpenAI / Anthropic / любой совместимый с OpenAI endpoint) и эмбеддинги (BGE-M3 / Google / совместимые с OpenAI).
- Нативен для MCP. Поставляется с сервером MCP, чтобы Claude Desktop / Cursor могли напрямую читать и записывать воспоминания.
Быстрый старт
Три способа запуска. Все используют один и тот же совместимый с Mem0 API.
1. Облако (нулевые операции)
export DEEPMEM_API_KEY=dm_live_...      # from https://deepmem.dev
curl https://deepmem.dev/v1/memories \
  -H "Authorization: Bearer $DEEPMEM_API_KEY" -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"I am Pat, I live in Lisbon."}],"user_id":"pat","infer":false}'
curl https://deepmem.dev/v1/memories/search \
  -H "Authorization: Bearer $DEEPMEM_API_KEY" -H "Content-Type: application/json" \
  -d '{"query":"Where does Pat live?","user_id":"pat"}'
2. Docker (одна команда)
cp .env.example .env          # add an LLM key
docker compose up --build     # DeepMem (HTTP :8000 + MCP :8001) + Qdrant sidecar
curl http://localhost:8000/health
Или загрузите опубликованный образ:
docker pull langdeepmem/deepmem:latest
docker run -p 8000:8000 -p 8001:8001 -e DEEPSEEK_API_KEY=sk-... langdeepmem/deepmem:latest
Образ открывает :8000 (HTTP) и :8001 (MCP). В Dockerfile и docker-compose.yml описаны варианты с GPU (CUDA torch + BGE_DEVICE=cuda) и параметры загрузки модели BGE-M3 (зеркало HF, прокси или локальный монтируемый том).
3. Из исходников
git clone https://github.com/deepmemteam/deepmem.git && cd deepmem
pip install -r requirements.txt
cp .env.example .env          # add an LLM key + embedder config
python server/start.py        # HTTP :8000 + MCP :8001
Запись и поиск в три строки:
import httpx
httpx.post("http://localhost:8000/v1/memories",
    json={"messages":[{"role":"user","content":"I'm Pat, I live in Lisbon."}],
          "user_id":"pat"})
print(httpx.post("http://localhost:8000/v1/memories/search",
    json={"query":"Where does Pat live?","user_id":"pat"}).json()["results"])
user_idнеобязателен (по умолчанию"default"); отправляйте разныеuser_id, чтобы изолировать конечных пользователей.infer: falseсохраняет сырой текст немедленно (удобно для тестирования); по умолчаниюinfer: trueставит в очередь для извлечения фактов с помощью LLM.
Основные возможности
Поддержка нескольких провайдеров через конфигурацию, а не код. Оба слоя переключаются через переменные окружения:
| Слой | Варианты | Селектор |
|---|---|---|
| LLM (извлечение фактов) | OpenAI · Anthropic (нативный SDK) · любой совместимый с OpenAI (DeepSeek / vLLM / Ollama / Groq / LM Studio) | LLM_PROVIDER + LLM_API_KEY / ANTHROPIC_API_KEY / DEEPSEEK_API_KEY |
| Эмбеддинги | BGE-M3 (локально, GPU/CPU) · Google Gemini · любой совместимый с OpenAI | EMBEDDING_PROVIDER + BGE_M3_PATH / GOOGLE_API_KEY / OPENAI_API_KEY |
BGE_DEVICE=auto|cpu|cuda выбирает GPU при наличии, иначе CPU (принудительно используйте cpu на картах с малым объёмом VRAM, чтобы избежать конкуренции между процессами). Переопределение LLM возможно для каждого запроса.
Гибридный поиск. Векторное сходство + ключевые слова BM25 + усиление сущностей + временное затухание объединяются в одну оценку. Избыточный выбор, переранжирование, возврат.
Асинхронная пакетная дистилляция. Записи ставятся в очередь за окном тишины и извлекаются пакетами — на ~80% меньше вызовов LLM, чем при извлечении по каждому сообщению.
Семантический кэш. Повторные добавления/поиски попадают в кэш с фильтрацией по схожести и возвращают кэшированные факты без повторного векторизации или запросов к Qdrant.
Хранит предпочтения, а не код. extraction_filter удаляет большие блоки кода в тройных обратных кавычках перед извлечением LLM, поэтому хранилище заполняется долговременными фактами, а не вставленными реализациями.
Сервер MCP. Инструменты deepmem_write / deepmem_search / deepmem_delete для Claude Desktop, Cursor и любых клиентов MCP.
GDPR. Мягкое удаление с окном хранения, жёсткое удаление reset, маскирование ID в логах с помощью SHA-256, экспорт/импорт для переносимости.
API
| Метод | Путь | Описание |
|---|---|---|
| POST | /v1/memories |
Запись сообщений; извлечение фактов с помощью LLM (infer=false хранит в сыром виде) |
| POST | /v1/memories/search |
Семантический поиск (векторный + BM25 + сущности + затухание по времени) |
| GET | /v1/memories |
Список всех записей для user_id (с пагинацией) |
| GET | /v1/memories/{id} |
Получение одной записи по ID |
| PUT | /v1/memories/{id} |
Обновление текста одной записи |
| DELETE | /v1/memories/{id} |
Мягкое удаление одной записи |
| DELETE | /v1/memories |
Мягкое удаление всех записей для user_id (GDPR) |
| GET | /v1/memories/{id}/history |
Журнал аудита ADD/UPDATE/DELETE |
| POST | /v1/reset |
Жёсткое удаление всех записей + журнала (требует confirm_user_id) |
| GET | /v1/export · POST /v1/import |
Портативный экспорт/импорт в формате JSON |
| GET | /health · /ready |
Проверки живучести/готовности |
agent_id / run_id опционально ограничивают область записи/чтения (зеркалит трёхуровневую изоляцию Mem0: пользователь → агент → запуск). Интерактивная документация доступна по адресу /docs.
Интеграция с MCP
Облачный сервис предоставляет удалённую конечную точку MCP (потоковая передача по HTTP):
URL:    https://deepmem.dev/mcp
Auth:   Authorization: Bearer dm_live_...   (your deepmem.dev API key)
Tools:  deepmem_write / deepmem_search
Работает с Claude Code, Claude Desktop, Cursor и любыми MCP-совместимыми клиентами.
Claude Code — одна команда:
claude mcp add --transport http deepmem https://deepmem.dev/mcp \
  --header "Authorization: Bearer dm_live_..."
Или установите плагин (включает команду /deepmem:setup, которая помогает настроить API-ключ):
/plugin marketplace add deepmemteam/deepmem-claude-plugin
/plugin install deepmem@deepmem
Cursor → Настройки → MCP → Добавить новый сервер MCP или отредактируйте ~/.cursor/mcp.json (глобально) / .cursor/mcp.json (для проекта). Cursor распознаёт переменные ${env:NAME} в url и headers, поэтому ключ может храниться в переменной окружения вместо файла конфигурации:
{
  "mcpServers": {
    "deepmem": {
      "url": "https://deepmem.dev/mcp",
      "headers": { "Authorization": "Bearer ${env:DEEPMEM_API_KEY}" }
    }
  }
}
(с DEEPMEM_API_KEY=dm_live_..., экспортированным в вашей оболочке, или вставьте ключ напрямую, если предпочитаете). Сообщество публикует списки MCP с кнопкой "Добавить в Cursor" на cursor.directory; официальные плагины доступны в Cursor Marketplace.
DeepSeek Harness (dsh) — один файл оверлея, плагин dsh не требуется (dsh подключается к любому серверу MCP через универсальный мост dsh-mcp-client):
export DEEPMEM_API_KEY=dm_live_...
dsh web --patch "$PWD/examples/dsh/deepmem.cordis.yml"
Подробности и варианты для самостоятельного хостинга см. в examples/dsh.
Самостоятельный хостинг (stdio, встроенный сервер, ключ не требуется в открытом режиме):
{
  "mcpServers": {
    "deepmem": {
      "command": "python",
      "args": ["server/mcp_server.py"],
      "env": { "DEEPMEMORY_BASE_URL": "http://localhost:8000" }
    }
  }
}
Этот репозиторий содержит предварительно настроенный .cursor/mcp.json для самостоятельного хостинга — откройте репозиторий в Cursor и включите его в Настройки → MCP.
Архитектура
client (HTTP / MCP)
  -> FastAPI (:8000)
       -> rate-limit middleware (per-IP token bucket on add/search)
       -> SemanticCache.check            (return cached facts on similarity hit)
       -> AsyncBatchDistiller.enqueue    (POST /v1/memories, infer=true)
            ↳ silence-window or max_batch triggers on_batch_ready
                ↳ VectorStore.process_batch  (LLM extraction -> Qdrant upsert)
       -> VectorStore.search             (vector + BM25 + entity + time-decay)
  -> LLM: OpenAI / Anthropic / OpenAI-compatible (fact extraction)
  -> BGE-M3 / Gemini / OpenAI-compatible (embeddings)
  -> Qdrant (vectors)  +  SQLite (audit history)
  -> MCP server (:8001)  deepmem_write / deepmem_search / deepmem_delete
Единственная коллекция Qdrant (memories), жёстко фильтруемая по полю user_id. TenantValidator нормализует в NFC и применяет ограничение набора символов [A-Za-z0-9._:-]{1,256} для user_id — никогда не доверяйте сырому значению из запроса.
Конфигурация
Конфигурация загружается один раз из переменных окружения (.env, загружается автоматически) > config.json > значения по умолчанию. Ключевые переменные:
| Переменная | Обязательно | Описание |
|---|---|---|
DEEPSEEK_API_KEY / LLM_API_KEY / ANTHROPIC_API_KEY |
один ключ LLM | LLM для извлечения фактов |
LLM_PROVIDER |
нет | auto / openai / anthropic / openai_compatible (по умолчанию auto) |
EMBEDDING_PROVIDER |
нет | bge-m3 / google / openai (по умолчанию bge-m3) |
BGE_M3_PATH |
нет | локальная директория BGE-M3 или ID модели HF (по умолчанию BAAI/bge-m3) |
BGE_DEVICE |
нет | auto / cpu / cuda (по умолчанию auto) |
QDRANT_URL / QDRANT_API_KEY |
нет | удалённый Qdrant; если не указано — локальное файловое хранилище |
CORS_ORIGINS |
да | разделённые запятыми разрешенные источники (не используйте * в продакшене) |
RATE_LIMIT_ADD / RATE_LIMIT_SEARCH |
нет | ограничения по количеству запросов в минуту (по умолчанию 30 / 60) |
Бэкенды автоматически переключаются на основе переменных окружения — изменения кода не требуются:
- Указан QDRANT_URL → удалённый Qdrant; не указан → локальный файловый Qdrant в ./data/qdrant.
- CORS_ORIGINS=* отклоняется при запуске, если не установлено DEEPMEMORY_DEBUG=1.
Production (systemd)
systemctl restart deepmem.service     # scripts/start.sh -> uvicorn :8000
journalctl -u deepmem -f
Для HTTPS поместите Caddy или Nginx перед сервером; scripts/start.sh запускается под systemd или любым другим менеджером процессов.
Бенчмарки
Два воспроизводимых скрипта в /benchmarks:
- Облако против облака — DeepMem Cloud против Mem0 Cloud. Зарегистрируйте ключи на deepmem.dev и mem0.ai, затем выполните
python benchmarks/benchmark_cloud.py. - Самостоятельный хостинг — ваш DeepMem, ваше оборудование (без ключей, без внешних сервисов):
python benchmarks/run_benchmark.py.
Оба скрипта содержат самодостаточную рабочую нагрузку и выводят P50/P95/P99 + пропускную способность. Показатели в начале этого README были получены с помощью этих скриптов — запустите их и посмотрите свои собственные перцентили.
Часто задаваемые вопросы
Нужен ли облачный сервис? Нет. Открытый сервер полностью функционален сам по себе. Облако (deepmem.dev) — это вариант без необходимости администрирования, с тем же API.
Работает ли офлайн? Поиск и базовое хранение (infer=false) работают без сети. Извлечение фактов с помощью LLM (infer=true) требует ключа LLM — или запустите локальную модель, совместимую с OpenAI (Ollama / vLLM / LM Studio), и укажите на неё LLM_BASE_URL.
Где хранятся мои данные? В вашем Qdrant (локальный файл или сервер) + журнал аудита SQLite. Ничего не покидает вашу машину, кроме вызовов LLM/эмбеддингов, которые вы настроите.
Поддержка мультитенантности? Да — одна коллекция Qdrant с жёсткой фильтрацией по user_id. agent_id / run_id добавляют область видимости для агента и сессии.
Готово ли это для продакшена? Используется в продакшене под systemd с удалённым Qdrant. Локальный файл Qdrant подходит для разработки или однопоточного режима; для многопоточного режима или высокой нагрузки используйте сервер Qdrant.
Разработка
pip install -r requirements.txt
DEEPMEMORY_DEBUG=1 python -m uvicorn server.main:app --reload --host 0.0.0.0 --port 8000
pytest tests/ -x -v
Лицензия
MIT.