whisper.cpp
by Georgi Gerganov (open source) Linux, macOS, Windows, Raspberry Pi, Android — CPU/GPU
Высокопроизводительная C++ реализация модели OpenAI Whisper для распознавания речи (STT) без зависимостей. Работает полностью локально, поддерживает все размеры моделей от tiny до large-v3. Возможности: - Распознавание речи офлайн, без API и интернета - Поддержка 99 языков, автодетект языка - Ускорение: CUDA, Metal (Apple), OpenCL, BLAS - Квантизация: модели от 75 MB (tiny.en.q5) до 3 GB (large-v3) - Вывод: txt, vtt, srt, lrc, json с таймкодами - Работает на Raspberry Pi и смартфонах - Привязки: Python, Go, Node.js, Ruby
Самохостируемая OpenAI-совместимая REST API для запуска LLM, изображений, аудио и эмбеддингов локально. Заменяет OpenAI API без …
Open source альтернатива ChatGPT, которая работает полностью офлайн. Desktop-приложение с красивым интерфейсом, встроенным управлением моделями и …
Самая известная коллекция промптов для LLM: 170+ готовых ролей и инструкций для ChatGPT и других моделей. …
Лучший бесплатный курс по LLM в формате GitHub-репо: от основ трансформеров до деплоя production-моделей. Более 200 …
# Сборка из исходников:
git clone https://github.com/ggerganov/whisper.cpp
cd whisper.cpp && make

# Загрузить модель:
bash ./models/download-ggml-model.sh base

# Распознать аудио:
./main -m models/ggml-base.bin -f audio.wav

# С субтитрами SRT:
./main -m models/ggml-base.bin -f audio.mp4 -osrt

# Python-пакет:
pip install pywhispercpp

# С GPU (CUDA):
make GGML_CUDA=1
whisper.cpp


High-performance inference of OpenAI's Whisper automatic speech recognition (ASR) model:
- Plain C/C++ implementation without dependencies
- Apple Silicon first-class citizen - optimized via ARM NEON, Accelerate framework, Metal and Core ML
- AVX intrinsics support for x86 architectures
- VSX intrinsics support for POWER architectures
- Mixed F16 / F32 precision
- Integer quantization support
- Zero memory allocations at runtime
- Vulkan support
- Support for CPU-only inference
- Efficient GPU support for NVIDIA
- AMD ROCm GPU support
- AMD Ryzen AI NPU Support
- OpenVINO Support
- Ascend NPU Support
- Moore Threads GPU Support
- C-style API
- Voice Activity Detection (VAD)
Supported platforms:
- [x] Mac OS (Intel and Arm)
- [x] iOS
- [x] Android
- [x] Java
- [x] Linux / FreeBSD
- [x] WebAssembly
- [x] Windows (MSVC and MinGW)
- [x] Raspberry Pi
- [x] Docker
The entire high-level implementation of the model is contained in whisper.h and whisper.cpp.
The rest of the code is part of the ggml machine learning library.
Having such a lightweight implementation of the model allows to easily integrate it in different platforms and applications. As an example, here is a video of running the model on an iPhone 13 device - fully offline, on-device: whisper.objc
https://user-images.githubusercontent.com/1991296/197385372-962a6dea-bca1-4d50-bf96-1d8c27b98c81.mp4
You can also easily make your own offline voice assistant application: command
https://user-images.githubusercontent.com/1991296/204038393-2f846eae-c255-4099-a76d-5735c25c49da.mp4
On Apple Silicon, the inference runs fully on the GPU via Metal:
https://github.com/ggml-org/whisper.cpp/assets/1991296/c82e8f86-60dc-49f2-b048-d2fdbd6b5225
Quick start
First clone the repository:
git clone https://github.com/ggml-org/whisper.cpp.git
Navigate into the directory:
cd whisper.cpp
Then, download one of the Whisper models converted in ggml format. For example:
sh ./models/download-ggml-model.sh base.en
Now build the whisper-cli example and transcribe an audio file like this:
# build the project
cmake -B build
cmake --build build -j --config Release

# transcribe an audio file
./build/bin/whisper-cli -f samples/jfk.wav
For a quick demo, simply run make base.en.
The command downloads the base.en model converted to custom ggml format and runs the inference on all .wav samples in the folder samples.
For detailed usage instructions, run: ./build/bin/whisper-cli -h
Note that the whisper-cli example currently runs only with 16-bit WAV files, so make sure to convert your input before running the tool.
For example, you can use ffmpeg like this:
ffmpeg -i input.mp3 -ar 16000 -ac 1 -c:a pcm_s16le output.wav
More audio samples
Дополнительные аудиофайлы для экспериментов
Если вы хотите скачать дополнительные аудиофайлы для работы, просто выполните:
make -j samples
Это загрузит несколько дополнительных аудиофайлов из Википедии и конвертирует их в формат 16-битного WAV с помощью ffmpeg.
Вы можете скачать и запустить другие модели следующим образом:
make -j tiny.en
make -j tiny
make -j base.en
make -j base
make -j small.en
make -j small
make -j medium.en
make -j medium
make -j large-v1
make -j large-v2
make -j large-v3
make -j large-v3-turbo
Использование памяти
| Модель | Диск | Память |
|---|---|---|
| tiny | 75 MiB | ~273 MB |
| base | 142 MiB | ~388 MB |
| small | 466 MiB | ~852 MB |
| medium | 1.5 GiB | ~2.1 GB |
| large | 2.9 GiB | ~3.9 GB |
Интринсики POWER VSX
whisper.cpp поддерживает архитектуры POWER и включает код, который значительно ускоряет работу на Linux на процессорах POWER9/10, делая его способным к транскрибации быстрее реального времени на пониженных частотах процессоров Raptor Talos II. Убедитесь, что у вас установлен пакет BLAS, и замените стандартную настройку cmake на:
# build with GGML_BLAS defined
cmake -B build -DGGML_BLAS=1
cmake --build build -j --config Release
./build/bin/whisper-cli [ .. etc .. ]
Квантование
whisper.cpp поддерживает целочисленное квантование моделей Whisper в формате ggml. Квантованные модели требуют меньше памяти и дискового пространства и, в зависимости от аппаратного обеспечения, могут обрабатываться более эффективно.
Вот шаги для создания и использования квантованной модели:
# quantize a model with Q5_0 method
cmake -B build
cmake --build build -j --config Release
./build/bin/quantize models/ggml-base.en.bin models/ggml-base.en-q5_0.bin q5_0

# run the examples as usual, specifying the quantized model file
./build/bin/whisper-cli -m models/ggml-base.en-q5_0.bin ./samples/gb0.wav
Поддержка Core ML
На устройствах Apple Silicon вычисления кодировщика могут выполняться на Neural Engine (ANE) через Core ML. Это может значительно ускорить работу — более чем в 3 раза быстрее, чем при выполнении только на CPU. Вот инструкции по созданию модели Core ML и её использованию с whisper.cpp:
-
Установите зависимости Python, необходимые для создания модели Core ML:
bash pip install ane_transformers pip install openai-whisper pip install coremltools- Убедитесь, что
coremltoolsработает корректно, подтвердите установку ... и выполнитеxcode-select --installдля установки командной строки. - Рекомендуется Python 3.11.
- Рекомендуется MacOS Sonoma (версия 14) или новее, так как старые версии MacOS могут испытывать проблемы с транскрибацией.
- [ОПЦИОНАЛЬНО] Рекомендуется использовать систему управления версиями Python, например ... для этого шага:
- Для создания окружения используйте:
conda create -n py311-whisper python=3.11 -y - Для активации окружения используйте:
conda activate py311-whisper
- Для создания окружения используйте:
- Убедитесь, что
-
Создайте модель Core ML. Например, для создания модели
base.enиспользуйте:bash ./models/generate-coreml-model.sh base.enЭто создаст папку
models/ggml-base.en-encoder.mlmodelc
-
Соберите
whisper.cppс поддержкой Core ML:```bash
с использованием CMake
cmake -B build -DWHISPER_COREML=1 cmake --build build -j --config Release ```
-
Запустите примеры, как обычно. Например:
```text $ ./build/bin/whisper-cli -m models/ggml-base.en.bin -f samples/jfk.wav
...
whisper_init_state: загрузка модели Core ML из 'models/ggml-base.en-encoder.mlmodelc' whisper_init_state: первый запуск на устройстве может занять некоторое время ... whisper_init_state: модель Core ML загружена
system_info: n_threads = 4 / 10 | AVX = 0 | AVX2 = 0 | AVX512 = 0 | FMA = 0 | NEON = 1 | ARM_FMA = 1 | F16C = 0 | FP16_VA = 1 | WASM_SIMD = 0 | BLAS = 1 | SSE3 = 0 | VSX = 0 | COREML = 1 |
... ```
Первый запуск на устройстве может быть медленным, так как ANE-сервис компилирует модель Core ML в некоторый формат, специфичный для устройства. Следующие запуски будут быстрее.
Для получения дополнительной информации о реализации Core ML обратитесь к PR ...
Поддержка OpenVINO
На платформах, поддерживающих ..., вычисления кодировщика могут выполняться на устройствах, поддерживаемых OpenVINO, включая x86-процессоры и графические процессоры Intel (встроенные и дискретные).
Это может значительно ускорить работу кодировщика. Вот инструкции по созданию модели OpenVINO и её использованию с whisper.cpp:
-
Сначала настройте виртуальное окружение Python и установите зависимости. Рекомендуется Python 3.10.
Windows:
powershell
cd models
python -m venv openvino_conv_env
openvino_conv_env\Scripts\activate
python -m pip install --upgrade pip
pip install -r requirements-openvino.txt
Linux и macOS:
bash
cd models
python3 -m venv openvino_conv_env
source openvino_conv_env/bin/activate
python -m pip install --upgrade pip
pip install -r requirements-openvino.txt
-
Создайте модель кодировщика OpenVINO. Например, для создания модели
base.enиспользуйте:python convert-whisper-to-openvino.py --model base.enThis will produce ggml-base.en-encoder-openvino.xml/.bin IR model files. It's recommended to relocate these to the same folder as
ggmlmodels, as that is the default location that the OpenVINO extension will search at runtime.
-
Build
whisper.cppwith OpenVINO support:Download OpenVINO package from release page. The recommended version to use is 2026.3.0. Ready to use Binaries of the required libraries can be found in the OpenVino Archives
After downloading & extracting package onto your development system, set up required environment by sourcing setupvars script. For example:
Linux:
bash
source /path/to/openvino_toolkit_ubuntu/setupvars.sh
Windows (cmd):
powershell
C:\Path\To\openvino_toolkit_windows\setupvars.bat
And then build the project using cmake:
bash
cmake -B build -DWHISPER_OPENVINO=1
cmake --build build -j --config Release
-
Run the examples as usual. For example:
```text $ ./build/bin/whisper-cli -m models/ggml-base.en.bin -f samples/jfk.wav
...
whisper_ctx_init_openvino_encoder: loading OpenVINO model from 'models/ggml-base.en-encoder-openvino.xml' whisper_ctx_init_openvino_encoder: first run on a device may take a while ... whisper_openvino_init: path_model = models/ggml-base.en-encoder-openvino.xml, device = GPU, cache_dir = models/ggml-base.en-encoder-openvino-cache whisper_ctx_init_openvino_encoder: OpenVINO model loaded
system_info: n_threads = 4 / 8 | AVX = 1 | AVX2 = 1 | AVX512 = 0 | FMA = 1 | NEON = 0 | ARM_FMA = 0 | F16C = 1 | FP16_VA = 0 | WASM_SIMD = 0 | BLAS = 0 | SSE3 = 1 | VSX = 0 | COREML = 0 | OPENVINO = 1 |
... ```
The first time run on an OpenVINO device is slow, since the OpenVINO framework will compile the IR (Intermediate Representation) model to a device-specific 'blob'. This device-specific blob will get cached for the next run.
For more information about the OpenVINO implementation please refer to PR #1037.
AMD Ryzen™ AI NPU support
On AMD Ryzen™ AI 300 and 400 Series processors with a dedicated NPU, whisper.cpp can fully offload the Whisper encoder to the NPU via VitisAI, delivering significant speedup over CPU-only inference.
Prerequisites
Supported Platforms
- Windows 11
- Linux (Ubuntu 24.04 LTS, Python 3.12)
Install the XRT runtime and FlexML runtime for your platform:
- XRT: provides the NPU kernel driver and
xrt-smidiagnostic tool — on Windows this is bundled with the NPU driver; on Linux install it separately following the NPU driver installation guide - FlexML runtime (
flexmlrt): VitisAI inference engine used by whisper.cpp — download from the FlexML runtime releases
After installing, source the setup scripts in every shell you use to build or run whisper.cpp:
# Linux
source /opt/xilinx/xrt/setup.sh
source /path/to/flexmlrt/setup.sh
:: Windows
cd /path/to/flexmlrt && call setup.bat
You can verify the NPU is visible with:
xrt-smi examine
Download models
Download the ggml model and the matching prebuilt VitisAI encoder cache:
# Linux / macOS
sh ./models/download-ggml-model.sh base
sh ./models/download-vitisai-model.sh base
:: Windows
.\models\download-ggml-model.cmd base
.\models\download-vitisai-model.cmd base
Use the same model name with both scripts. To see all available VitisAI encoder caches:
sh ./models/download-vitisai-model.sh --list
.\models\download-vitisai-model.cmd --list
The VitisAI script queries the AMD Ryzen AI Whisper NPU collection on Hugging Face and downloads the .rai encoder cache as models/ggml-<model>-encoder-vitisai.rai.
Depending on the
.raicache, VitisAI may offload the encoder only, or the encoder plus cross-projection layers. whisper.cpp detects this at runtime and logs the selected offload mode during model initialization.
Build
cmake -B build -DWHISPER_VITISAI=1
cmake --build build -j --config Release
Run
./build/bin/whisper-cli -m models/ggml-base.bin -f samples/jfk.wav
For more information see the Ryzen AI documentation.
NVIDIA GPU support
With NVIDIA cards the processing of the models is done efficiently on the GPU via cuBLAS and custom CUDA kernels.
First, make sure you have installed cuda: https://developer.nvidia.com/cuda-downloads
Теперь соберите whisper.cpp с поддержкой CUDA:
cmake -B build -DGGML_CUDA=1
cmake --build build -j --config Release
или для более новых видеокарт NVIDIA (серия RTX 5000):
cmake -B build -DGGML_CUDA=1 -DCMAKE_CUDA_ARCHITECTURES="86"
cmake --build build -j --config Release
Поддержка GPU Vulkan
Кросс-платформенное решение, позволяющее ускорить обработку на вашем GPU. Сначала убедитесь, что драйвер вашей видеокарты поддерживает API Vulkan.
Теперь соберите whisper.cpp с поддержкой Vulkan:
cmake -B build -DGGML_VULKAN=1
cmake --build build -j --config Release
Поддержка GPU AMD ROCm
С видеокартами AMD обработка может быть ускорена через HIP/ROCm. Сначала убедитесь, что у вас установлен ...
Теперь соберите whisper.cpp с поддержкой HIP:
cmake -B build -DGGML_HIP=1 -DAMDGPU_TARGETS="gfx1201"
cmake --build build -j --config Release
Замените gfx1201 на архитектуру вашего GPU. Вы можете найти её с помощью:
rocminfo | grep "gfx"
Распространённые архитектуры: gfx1100 (RX 7900 XTX), gfx1101 (RX 7800 XT), gfx1201 (RX 9070 XT).
Для нескольких GPU с разными архитектурами: ...
Поддержка BLAS CPU через OpenBLAS
Обработку кодировщика можно ускорить на CPU через OpenBLAS.
Сначала убедитесь, что у вас установлен openblas: https://www.openblas.net/
Теперь соберите whisper.cpp с поддержкой OpenBLAS:
cmake -B build -DGGML_BLAS=1
cmake --build build -j --config Release
Поддержка NPU Ascend
NPU Ascend обеспечивает ускорение вывода через ... и AI-ядра.
Сначала проверьте, поддерживается ли ваше устройство Ascend NPU:
Проверенные устройства
| Ascend NPU | Status |
|---|---|
| Atlas 300T A2 | Поддержка |
| Atlas 300I Duo | Поддержка |
Затем убедитесь, что у вас установлен [`CANN ... . Рекомендуется использовать последнюю версию CANN.
Теперь соберите whisper.cpp с поддержкой CANN:
cmake -B build -DGGML_CANN=1
cmake --build build -j --config Release
Запустите примеры вывода так же, как обычно, например:
./build/bin/whisper-cli -f samples/jfk.wav -m models/ggml-base.en.bin -t 8
Примечания:
- Если у вас возникли проблемы с устройством Ascend NPU, пожалуйста, создайте issue с префиксом/тегом [CANN].
- Если вы успешно запустили вывод с вашим устройством Ascend NPU, пожалуйста, помогите обновить таблицу
Проверенные устройства.
Поддержка GPU Moore Threads
С картами Moore Threads обработка моделей выполняется эффективно на GPU через muBLAS и пользовательские ядра MUSA.
Сначала убедитесь, что у вас установлен MUSA SDK rc4.2.0: https://developer.mthreads.com/sdk/download/musa?equipment=&os=&driverVersion=&version=4.2.0
Теперь соберите whisper.cpp с поддержкой MUSA:
cmake -B build -DGGML_MUSA=1
cmake --build build -j --config Release
или укажите архитектуру для вашего GPU Moore Threads. Например, если у вас есть GPU MTT S80, вы можете указать архитектуру следующим образом:
cmake -B build -DGGML_MUSA=1 -DMUSA_ARCHITECTURES="21"
cmake --build build -j --config Release
Поддержка FFmpeg (только примеры)
По умолчанию примеры в этом репозитории используют библиотеку ... для декодирования аудиофайлов.
Некоторые примеры также могут использовать FFmpeg для декодирования и поддержки более широкого формата. Чтобы включить эту функцию, соберите с WHISPER_COMMON_FFMPEG.
Сначала вам нужно установить необходимые библиотеки:
# Debian/Ubuntu
sudo apt install libavcodec-dev libavformat-dev libavutil-dev

# RHEL/Fedora
sudo dnf install libavcodec-free-devel libavformat-free-devel libavutil-free-devel
Затем вы можете собрать проект следующим образом:
cmake -B build -D WHISPER_COMMON_FFMPEG=yes
cmake --build build
Запустите следующий пример, чтобы подтвердить его работу:
# Convert an audio file to Opus format
ffmpeg -i samples/jfk.wav jfk.opus

# Transcribe the audio file
./build/bin/whisper-cli --model models/ggml-base.en.bin --file jfk.opus
Docker
Предварительные требования
- Docker должен быть установлен и запущен на вашей системе.
- Создайте папку для хранения больших моделей и промежуточных файлов (например, /whisper/models)
Образы
У нас есть несколько Docker-образов для этого проекта:
- ... Этот образ включает основной исполняемый файл, а также
curlиffmpeg. (платформы:linux/amd64,linux/arm64) - ... То же, что и
main, но с поддержкой CUDA. (платформы:linux/amd64) - ... То же, что и
main, но с поддержкой MUSA. (платформы:linux/amd64) - ... То же, что и
main, но с поддержкой Vulkan. (платформы:linux/amd64)
Использование
# download model and persist it in a local folder
docker run -it --rm \
  -v path/to/models:/models \
  whisper.cpp:main "./models/download-ggml-model.sh base /models"

# transcribe an audio file
docker run -it --rm \
  -v path/to/models:/models \
  -v path/to/audios:/audios \
  whisper.cpp:main "whisper-cli -m /models/ggml-base.bin -f /audios/jfk.wav"

# transcribe an audio file in samples folder
docker run -it --rm \
  -v path/to/models:/models \
  whisper.cpp:main "whisper-cli -m /models/ggml-base.bin -f ./samples/jfk.wav"

# run the web server
docker run -it --rm -p "8080:8080" \
  -v path/to/models:/models \
  whisper.cpp:main "whisper-server --host 127.0.0.1 -m /models/ggml-base.bin"

# run the bench too on the small.en model using 4 threads
docker run -it --rm \
  -v path/to/models:/models \
  whisper.cpp:main "whisper-bench -m /models/ggml-small.en.bin -t 4"
Установка с помощью Conan
Вы можете установить предварительно собранные бинарные файлы для whisper.cpp или собрать его из исходников с помощью Conan. Используйте следующую команду:
conan install --requires="whisper-cpp/[*]" --build=missing
Для получения подробных инструкций по использованию Conan, пожалуйста, обратитесь к [Conan ...
Ограничения
- Только вывод
Пример реального времени аудиоввода
Это наивный пример выполнения вывода в реальном времени с аудио с вашего микрофона. Инструмент ... сэмплирует аудио каждые полсекунды и непрерывно выполняет транскрипцию. Больше информации доступно в issue ... Вам потребуется установить ... для корректной работы.
cmake -B build -DWHISPER_SDL2=ON
cmake --build build -j --config Release
./build/bin/whisper-stream -m ./models/ggml-base.en.bin -t 8 --step 500 --length 5000
https://user-images.githubusercontent.com/1991296/194935793-76afede7-cfa8-48d8-a80f-28ba83be7d09.mp4
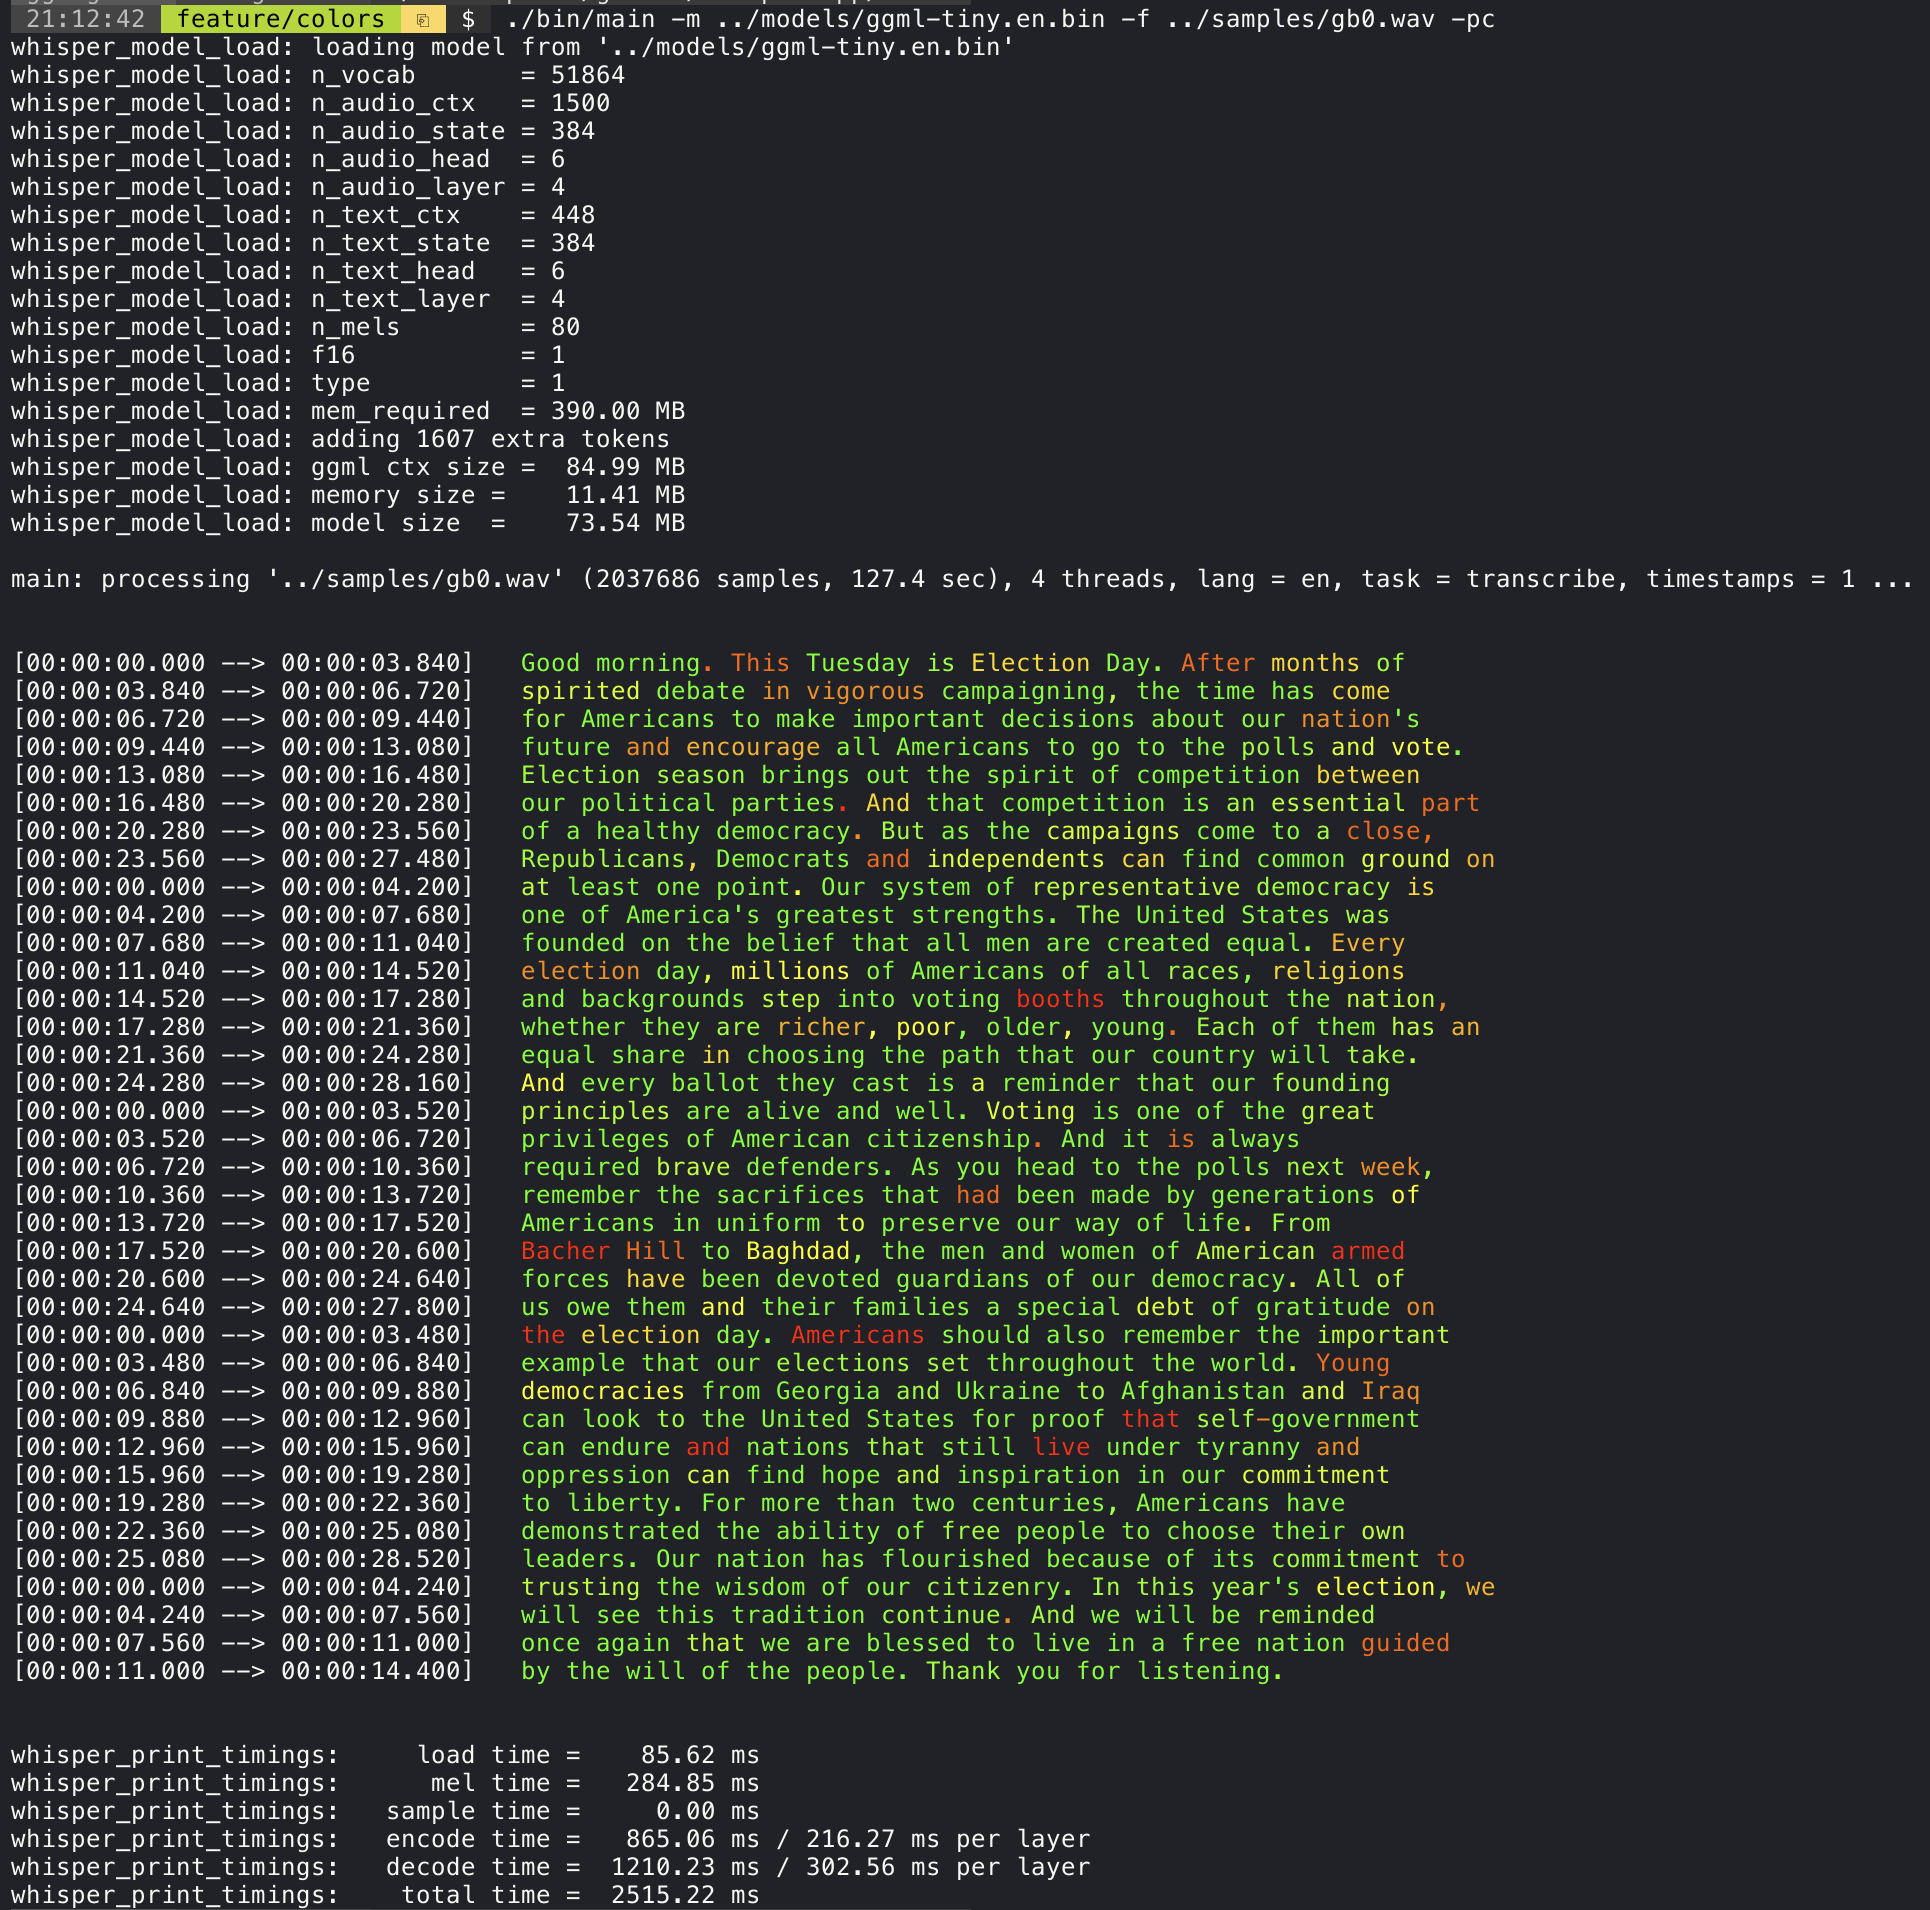
Цветовое кодирование уверенности
Добавление аргумента --print-colors выведет транскрибированный текст с использованием экспериментальной стратегии цветового кодирования, чтобы выделить слова с высокой или низкой уверенностью:
./build/bin/whisper-cli -m models/ggml-base.en.bin -f samples/gb0.wav --print-colors
Управление длиной сгенерированных текстовых сегментов (экспериментально)
Например, чтобы ограничить длину строки максимум 16 символами, просто добавьте -ml 16:
$ ./build/bin/whisper-cli -m ./models/ggml-base.en.bin -f ./samples/jfk.wav -ml 16

whisper_model_load: loading model from './models/ggml-base.en.bin'
...
system_info: n_threads = 4 / 10 | AVX2 = 0 | AVX512 = 0 | NEON = 1 | FP16_VA = 1 | WASM_SIMD = 0 | BLAS = 1 |

main: processing './samples/jfk.wav' (176000 samples, 11.0 sec), 4 threads, 1 processors, lang = en, task = transcribe, timestamps = 1 ...

[00:00:00.000 --> 00:00:00.850]   And so my
[00:00:00.850 --> 00:00:01.590]   fellow
[00:00:01.590 --> 00:00:04.140]   Americans, ask
[00:00:04.140 --> 00:00:05.660]   not what your
[00:00:05.660 --> 00:00:06.840]   country can do
[00:00:06.840 --> 00:00:08.430]   for you, ask
[00:00:08.430 --> 00:00:09.440]   what you can do
[00:00:09.440 --> 00:00:10.020]   for your
[00:00:10.020 --> 00:00:11.000]   country.
Таймстампы на уровне слов (экспериментально)
Аргумент --max-len можно использовать для получения таймстампов на уровне слов. Просто используйте -ml 1:
$ ./build/bin/whisper-cli -m ./models/ggml-base.en.bin -f ./samples/jfk.wav -ml 1

whisper_model_load: loading model from './models/ggml-base.en.bin'
...
system_info: n_threads = 4 / 10 | AVX2 = 0 | AVX512 = 0 | NEON = 1 | FP16_VA = 1 | WASM_SIMD = 0 | BLAS = 1 |

main: processing './samples/jfk.wav' (176000 samples, 11.0 sec), 4 threads, 1 processors, lang = en, task = transcribe, timestamps = 1 ...

[00:00:00.000 --> 00:00:00.320]
[00:00:00.320 --> 00:00:00.370]   And
[00:00:00.370 --> 00:00:00.690]   so
[00:00:00.690 --> 00:00:00.850]   my
[00:00:00.850 --> 00:00:01.590]   fellow
[00:00:01.590 --> 00:00:02.850]   Americans
[00:00:02.850 --> 00:00:03.300]  ,
[00:00:03.300 --> 00:00:04.140]   ask
[00:00:04.140 --> 00:00:04.990]   not
[00:00:04.990 --> 00:00:05.410]   what
[00:00:05.410 --> 00:00:05.660]   your
[00:00:05.660 --> 00:00:06.260]   country
[00:00:06.260 --> 00:00:06.600]   can
[00:00:06.600 --> 00:00:06.840]   do
[00:00:06.840 --> 00:00:07.010]   for
[00:00:07.010 --> 00:00:08.170]   you
[00:00:08.170 --> 00:00:08.190]  ,
[00:00:08.190 --> 00:00:08.430]   ask
[00:00:08.430 --> 00:00:08.910]   what
[00:00:08.910 --> 00:00:09.040]   you
[00:00:09.040 --> 00:00:09.320]   can
[00:00:09.320 --> 00:00:09.440]   do
[00:00:09.440 --> 00:00:09.760]   for
[00:00:09.760 --> 00:00:10.020]   your
[00:00:10.020 --> 00:00:10.510]   country
[00:00:10.510 --> 00:00:11.000]  .
Сегментация говорящих через tinydiarize (экспериментально)
Больше информации об этом подходе доступно здесь: https://github.com/ggml-org/whisper.cpp/pull/1058
Пример использования:
# download a tinydiarize compatible model
./models/download-ggml-model.sh small.en-tdrz

# run as usual, adding the "-tdrz" command-line argument
./build/bin/whisper-cli -f ./samples/a13.wav -m ./models/ggml-small.en-tdrz.bin -tdrz
...
main: processing './samples/a13.wav' (480000 samples, 30.0 sec), 4 threads, 1 processors, lang = en, task = transcribe, tdrz = 1, timestamps = 1 ...
...
[00:00:00.000 --> 00:00:03.800]   Okay Houston, we've had a problem here. [SPEAKER_TURN]
[00:00:03.800 --> 00:00:06.200]   This is Houston. Say again please. [SPEAKER_TURN]
[00:00:06.200 --> 00:00:08.260]   Uh Houston we've had a problem.
[00:00:08.260 --> 00:00:11.320]   We've had a main beam up on a volt. [SPEAKER_TURN]
[00:00:11.320 --> 00:00:13.820]   Roger main beam interval. [SPEAKER_TURN]
[00:00:13.820 --> 00:00:15.100]   Uh uh [SPEAKER_TURN]
[00:00:15.100 --> 00:00:18.020]   So okay stand, by thirteen we're looking at it. [SPEAKER_TURN]
[00:00:18.020 --> 00:00:25.740]   Okay uh right now uh Houston the uh voltage is uh is looking good um.
[00:00:27.620 --> 00:00:29.940]   And we had a a pretty large bank or so.
Генерация видеороликов в стиле караоке (экспериментально)
Пример предоставляет поддержку вывода видеороликов в стиле караоке, где подсвечивается текущее произносимое слово. Используйте аргумент -owts и запустите сгенерированный bash-скрипт. Для этого потребуется установленный ffmpeg.
Вот несколько "типичных" примеров:
./build/bin/whisper-cli -m ./models/ggml-base.en.bin -f ./samples/jfk.wav -owts
source ./samples/jfk.wav.wts
ffplay ./samples/jfk.wav.mp4
https://user-images.githubusercontent.com/1991296/199337465-dbee4b5e-9aeb-48a3-b1c6-323ac4db5b2c.mp4
./build/bin/whisper-cli -m ./models/ggml-base.en.bin -f ./samples/mm0.wav -owts
source ./samples/mm0.wav.wts
ffplay ./samples/mm0.wav.mp4
https://user-images.githubusercontent.com/1991296/199337504-cc8fd233-0cb7-4920-95f9-4227de3570aa.mp4
./build/bin/whisper-cli -m ./models/ggml-base.en.bin -f ./samples/gb0.wav -owts
source ./samples/gb0.wav.wts
ffplay ./samples/gb0.wav.mp4
https://user-images.githubusercontent.com/1991296/199337538-b7b0c7a3-2753-4a88-a0cd-f28a317987ba.mp4
Сравнение видео разных моделей
Используйте ... скрипт для генерации видео в следующем формате:
./scripts/bench-wts.sh samples/jfk.wav
ffplay ./samples/jfk.wav.all.mp4
https://user-images.githubusercontent.com/1991296/223206245-2d36d903-cf8e-4f09-8c3b-eb9f9c39d6fc.mp4
Бенчмарки
Для объективного сравнения производительности инференса на разных конфигурациях систем используйте ... инструмент. Инструмент просто запускает часть модели Encoder и выводит время, затраченное на её выполнение. Результаты суммированы в следующем Github issue:
Кроме того, предоставляется скрипт для запуска whisper.cpp с разными моделями и аудиофайлами ...
Его можно запустить с помощью следующей команды, по умолчанию он будет работать с любой стандартной моделью в папке models.
python3 scripts/bench.py -f samples/jfk.wav -t 2,4,8 -p 1,2
Он написан на python с целью быть простым в модификации и расширении для вашего случая бенчмаркинга.
Он выводит csv-файл с результатами бенчмаркинга.
ggml формат
Оригинальные модели конвертируются в пользовательский бинарный формат. Это позволяет упаковать всё необходимое в один файл:
- параметры модели
- мел-фильтры
- словарь
- веса
Вы можете скачать конвертированные модели с помощью ... скрипта или вручную отсюда:
- https://huggingface.co/ggerganov/whisper.cpp
Для более подробной информации см. скрипт конвертации ... или ...
...
- [x] Rust: ... | ...
- [x] JavaScript: ... | ...
- React Native (iOS / Android): ...
- [x] Go: ... | ...
- [x] Java: ...
XCFramework
XCFramework — это предварительно скомпилированная версия библиотеки для iOS, visionOS, tvOS и macOS. Её можно использовать в проектах Swift без необходимости компилировать библиотеку из исходников. Например, версия XCFramework v1.7.5 можно использовать следующим образом:
// swift-tools-version: 5.10
// The swift-tools-version declares the minimum version of Swift required to build this package.

import PackageDescription

let package = Package(
    name: "Whisper",
    targets: [
        .executableTarget(
            name: "Whisper",
            dependencies: [
                "WhisperFramework"
            ]),
        .binaryTarget(
            name: "WhisperFramework",
            url: "https://github.com/ggml-org/whisper.cpp/releases/download/v1.7.5/whisper-v1.7.5-xcframework.zip",
            checksum: "c7faeb328620d6012e130f3d705c51a6ea6c995605f2df50f6e1ad68c59c6c4a"
        )
    ]
)
Обнаружение голоса (VAD)
Поддержка обнаружения голоса (VAD) может быть включена с помощью аргумента --vad в whisper-cli. Кроме этого, также требуется модель VAD.
Это работает так: сначала аудио-образцы передаются через модель VAD, которая обнаруживает сегменты речи. Используя эту информацию, из исходного аудиовхода извлекаются только обнаруженные сегменты речи и передаются в whisper для обработки. Это уменьшает количество аудиоданных, которые нужно обработать whisper, и значительно ускоряет процесс транскрибации.
В настоящее время поддерживаются следующие модели VAD:
Silero-VAD
... — это лёгкая модель VAD, написанная на Python, которая быстрая и точная.
Модели можно скачать, выполнив следующую команду в Linux или MacOS:
$ ./models/download-vad-model.sh silero-v6.2.0
Downloading ggml model silero-v6.2.0 from 'https://huggingface.co/ggml-org/whisper-vad' ...
ggml-silero-v6.2.0.bin        100%[==============================================>] 864.35K  --.-KB/s    in 0.04s
Done! Model 'silero-v6.2.0' saved in '/path/models/ggml-silero-v6.2.0.bin'
You can now use it like this:

  $ ./build/bin/whisper-cli -vm /path/models/ggml-silero-v6.2.0.bin --vad -f samples/jfk.wav -m models/ggml-base.en.bin
А в Windows — следующую команду:
> .\models\download-vad-model.cmd silero-v6.2.0
Downloading vad model silero-v6.2.0...
Done! Model silero-v6.2.0 saved in C:\Users\danie\work\ai\whisper.cpp\ggml-silero-v6.2.0.bin
You can now use it like this:

C:\path\build\bin\Release\whisper-cli.exe -vm C:\path\ggml-silero-v6.2.0.bin --vad -m models/ggml-base.en.bin -f samples\jfk.wav
Чтобы увидеть список всех доступных моделей, выполните вышеуказанные команды без аргументов.
Эту модель также можно вручную преобразовать в ggml с помощью следующей команды:
$ python3 -m venv venv && source venv/bin/activate
$ (venv) pip install silero-vad
$ (venv) $ python models/convert-silero-vad-to-ggml.py --output models/silero.bin
Saving GGML Silero-VAD model to models/silero-v6.2.0-ggml.bin
После этого её можно использовать с whisper следующим образом:
$ ./build/bin/whisper-cli \
   --file ./samples/jfk.wav \
   --model ./models/ggml-base.en.bin \
   --vad \
   --vad-model ./models/silero-v6.2.0-ggml.bin
Опции VAD
--vad-threshold: Порог вероятности для обнаружения речи. Вероятность для сегмента/кадра речи выше этого порога будет считаться речью.
--vad-min-speech-duration-ms: Минимальная длительность речи в миллисекундах. Сегменты речи короче этого значения будут отброшены для фильтрации кратких шумов или ложных срабатываний.
--vad-min-silence-duration-ms: Минимальная длительность тишины в миллисекундах. Периоды тишины должны быть не короче этого значения, чтобы завершить сегмент речи. Короче тишина будет игнорироваться и включаться в речь.
--vad-max-speech-duration-s: Максимальная длительность речи в секундах. Сегменты речи длиннее этого значения будут автоматически разделены на несколько сегментов в точках тишины, превышающих 98 мс, чтобы предотвратить чрезмерно длинные сегменты.
--vad-speech-pad-ms: Дополнительная задержка речи в миллисекундах. Добавляет это количество задержки до и после каждого обнаруженного сегмента речи, чтобы избежать обрезки края речи.
--vad-samples-overlap: Количество аудио, которое нужно расширить из каждого сегмента речи в следующий, в секундах (например, 0,10 = 100 мс перекрытия). Это гарантирует, что речь не будет резко обрываться между сегментами при их объединении.
Примеры
В папке ... есть различные примеры использования библиотеки для разных проектов. Некоторые из примеров даже перенесены для работы в браузере с помощью WebAssembly. Посмотрите их!
| Пример | Веб | Описание | | --------------------------------------------------- | ------------------------------------- | ... | | ... | ... | Инструмент для перевода и транскрибации аудио с использованием Whisper | | ... | ... | Тестирование производительности Whisper на вашем компьютере | | ... | ... | Реальная транскрибация сырого захвата микрофона | | ... | ... | Пример голосового помощника для получения голосовых команд с микрофона | | ... | | HTTP-сервер транскрибации с API, похожим на OAI | | ... | | Разговор с ботом LLaMA | | ... | | Мобильное приложение для iOS с использованием whisper.cpp | | ... | | Приложение SwiftUI для iOS / macOS с использованием whisper.cpp | | ... | | Мобильное приложение для Android с использованием whisper.cpp | | ... | | Плагин для Neovim для преобразования речи в текст | | ... | | Вспомогательный скрипт для лёгкого [создания караоке-трека из сырого аудиозахвата] | | ... | | [Трансляция аудио в прямом эфире] | | ... | | Скачивание + транскрибация и/или перевод любого VOD ... | | ... | ... | Шахматы с голосовым управлением |
...
Если у вас есть какие-либо отзывы о проекте, не стесняйтесь использовать раздел Discussions и открыть новую тему.
Вы можете использовать категорию [Show and ... для того, чтобы поделиться своими собственными проектами, которые используют whisper.cpp. Если у вас есть вопрос, убедитесь, что вы проверили раздел [Frequently asked questions ... discussion.